
Analyse pratique du Lazy Loading, du Batch Fetching, de JOIN FETCH et de @EntityGraph avec Spring Boot, Hibernate et Spring Data JPA.
Lorsqu’une application Java utilise Hibernate pour accéder à une base de données relationnelle, le fonctionnement du chargement des associations entre entités peut avoir un impact important sur ses performances. Une application peut sembler parfaitement correcte au niveau du code Java tout en générant un nombre excessif de requêtes SQL lors de son exécution.
Le problème des requêtes N+1 est l’un des exemples les plus courants. Il apparaît notamment lorsqu’une première requête permet de récupérer une collection d’entités, puis que l’accès à une association configurée LAZY provoque une nouvelle requête SQL pour chaque entité parcourue.
Dans une application manipulant quelques enregistrements, cette situation peut passer inaperçue. Lorsque le volume de données augmente ou que les mêmes opérations sont exécutées simultanément par de nombreux utilisateurs, la multiplication des allers-retours vers la base de données peut en revanche devenir un véritable problème de performance.
Pour étudier concrètement ce comportement, j’ai réalisé une démonstration avec Spring Boot, Spring Data JPA et Hibernate, en utilisant un modèle simplifié d’investissement composé d’investisseurs et de portefeuilles financiers. Le projet associé permet d’observer le comportement du chargement des données et de comparer plusieurs stratégies d’accès.
Nous allons partir du problème N+1 observé avec le chargement différé, puis étudier deux mécanismes permettant de le réduire : le Batch Fetching et le JOIN FETCH. Nous examinerons également @EntityGraph, avant de comparer leurs avantages, leurs limites et leurs cas d’utilisation.
L’objectif n’est pas de déterminer quelle solution est systématiquement la meilleure, mais de comprendre comment Hibernate charge réellement les données et comment choisir une stratégie adaptée au cas d’usage.
1. Comprendre le problème des requêtes N+1 avec Hibernate
Le problème des requêtes N+1 apparaît lorsqu’une application exécute une première requête pour récupérer une collection d’entités, puis déclenche des requêtes supplémentaires pour charger une association liée à chacune de ces entités.
Le phénomène est particulièrement fréquent avec Hibernate lorsque les associations sont configurées avec le chargement différé, ou Lazy Loading. Cette stratégie permet d’éviter de récupérer immédiatement des données qui ne sont pas nécessaires au cas d’usage. Cependant, lorsqu’une application parcourt ensuite une association pour chaque entité récupérée, Hibernate peut générer une requête SQL supplémentaire pour chaque élément.
Le résultat peut alors prendre la forme suivante : 1 requête initiale + N requêtes supplémentaires = N + 1 requêtes.
Pour comprendre concrètement ce mécanisme, nous allons utiliser un cas d’étude basé sur une plateforme d’investissement dans laquelle un investisseur peut posséder plusieurs portefeuilles financiers.
Le modèle est volontairement simple afin de pouvoir observer précisément le comportement d’Hibernate et les requêtes SQL générées lors de l’accès aux données.
1.1. Le modèle de domaine
Pour reproduire le problème N+1 dans un contexte suffisamment proche d’une application métier réelle, nous allons utiliser un modèle simplifié de plateforme d’investissement.
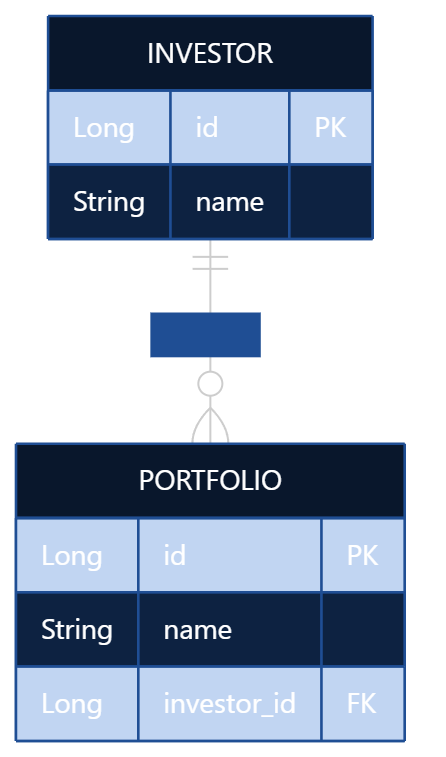
Dans ce modèle, un Investor représente un investisseur et un Portfolio représente l’un de ses portefeuilles financiers. Un investisseur peut donc être associé à plusieurs portefeuilles.
Au niveau de la base de données, cette relation est représentée par une clé étrangère investor_id dans la table des portefeuilles.
Du côté de JPA, cette relation est modélisée par une association @OneToMany entre Investor et Portfolio. La collection des portefeuilles est configurée avec FetchType.LAZY, ce qui signifie que les portefeuilles ne sont pas chargés au moment où l’investisseur est récupéré.
Ce choix est important pour la suite de l’expérience : nous allons voir comment cet accès différé aux données peut conduire Hibernate à exécuter plusieurs requêtes SQL lorsque l’application parcourt les portefeuilles de plusieurs investisseurs.
package com.aroolia.performance.batchfetching.model;

import jakarta.persistence.*;
import java.util.ArrayList;
import java.util.List;

@Entity
@Table(name = "t_investors")
public class Investor {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @Column(nullable = false)
    private String name;

    @OneToMany(
        mappedBy = "investor",
        fetch = FetchType.LAZY,
        cascade = CascadeType.ALL,
        orphanRemoval = true
    )
    private List<Portfolio> portfolios = new ArrayList<>();

    public Investor() {}

    public Investor(String name) {
        this.name = name;
    }

    public void addPortfolio(Portfolio portfolio) {
        portfolios.add(portfolio);
        portfolio.setInvestor(this);
    }

    public Long getId() {
        return id;
    }

    public String getName() {
        return name;
    }

    public List<Portfolio> getPortfolios() {
        return portfolios;
    }
}
package com.aroolia.performance.batchfetching.model;
import jakarta.persistence.*;
@Entity
@Table(name = "t_portfolios")
public class Portfolio {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Long id;
@Column(nullable = false)
private String name;
@ManyToOne(fetch = FetchType.LAZY)
@JoinColumn(name = "investor_id", nullable = false)
private Investor investor;
public Portfolio() {}
public Portfolio(String name, Investor investor) {
this.name = name;
this.investor = investor;
}
public Long getId() {
return id;
}
public String getName() {
return name;
}
public Investor getInvestor() {
return investor;
}
public void setInvestor(Investor investor) {
this.investor = investor;
}
}1.2. Le déclenchement du problème N+1
Le problème devient visible lorsque l’application récupère d’abord la liste des investisseurs, puis accède à leurs portefeuilles au cours du traitement.
Dans notre cas, le repository utilise une requête standard findAll(). Cette requête récupère les investisseurs, mais elle ne demande pas explicitement à Hibernate de charger leurs portefeuilles.
Lorsque le service appelle ensuite investor.getPortfolios().size(), Hibernate doit initialiser la collection portfolios. Comme cette association est configurée avec FetchType.LAZY, son contenu n’a pas encore été chargé.
Hibernate exécute alors une requête SQL pour récupérer les portefeuilles associés à l’investisseur concerné.
Si plusieurs investisseurs sont parcourus et que leur collection portfolios est consultée individuellement, le même mécanisme se répète pour chacun d’entre eux.
C’est cette succession d’une requête initiale suivie de requêtes supplémentaires qui constitue le problème des requêtes N+1.
@Transactional(readOnly = true)
public List<PortfolioSummary> getInvestorSummariesWithNPlusOne() {
    List<Investor> investors = investorRepository.findAll();

    return investors.stream()
            .map(investor -> new PortfolioSummary(
                    investor.getName(),
                    investor.getPortfolios().size()
            ))
            .collect(Collectors.toList());
}Schéma du mécanisme :
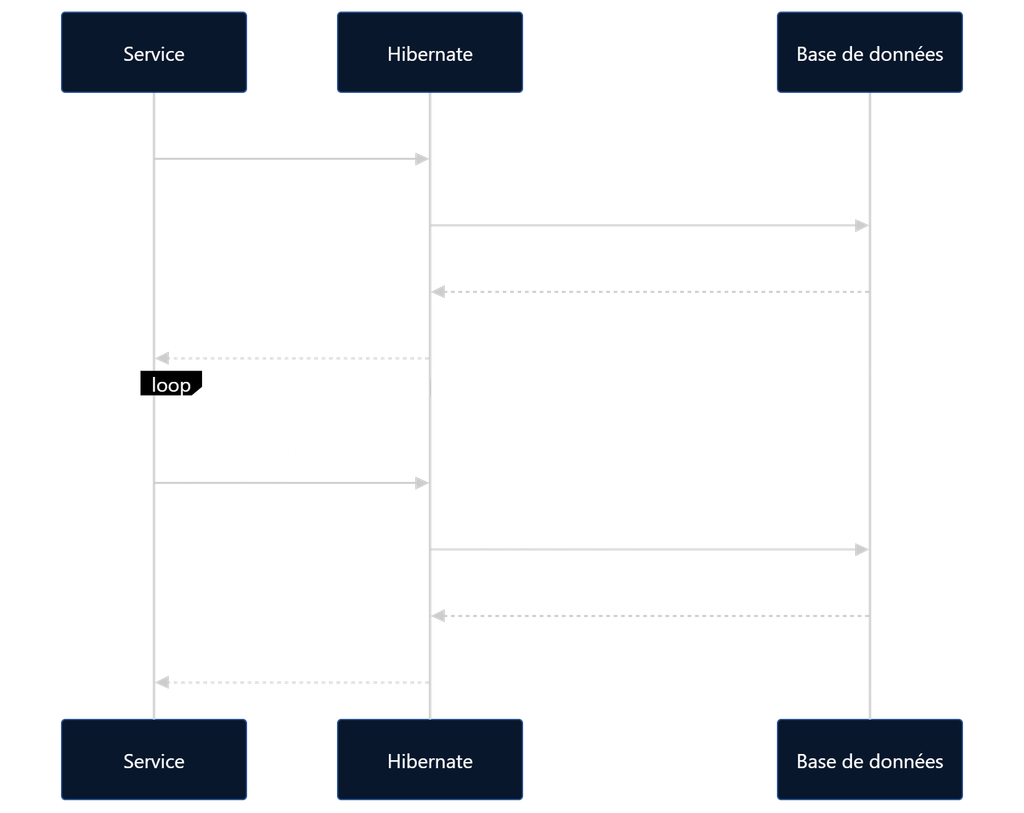
La première étape consiste à récupérer les investisseurs. Comme le repository utilise findAll() sans demander explicitement le chargement des portefeuilles, Hibernate commence par exécuter une requête portant uniquement sur la table des investisseurs.
SELECT
    id,
    name
FROM
t_investors;Lorsque le code accède à investor.getPortfolios().size(), Hibernate initialise la collection différée. Pour chaque investisseur concerné, une requête est alors exécutée afin de récupérer les portefeuilles associés.
SELECT
id,
name,
investor_id
FROM
t_portfolios
WHERE
investor_id = ?;1.3. Pourquoi le N+1 est un problème de performance
Le problème N+1 ne signifie pas nécessairement que chacune des requêtes SQL exécutées par l’application est coûteuse individuellement. Le problème vient principalement de leur multiplication.
Chaque requête supplémentaire implique un échange entre l’application et le système de gestion de base de données. Lorsque le nombre d’entités augmente, le nombre d’allers-retours augmente lui aussi.
Dans notre scénario, la récupération de 10 investisseurs nécessite une première requête pour récupérer les investisseurs, puis une requête supplémentaire pour chacun des 10 investisseurs lorsque leurs portefeuilles sont consultés. Le résultat est donc de 11 requêtes SQL au lieu d’une stratégie permettant de regrouper ou de contrôler le chargement des données.
La différence devient particulièrement intéressante lorsque le même modèle est appliqué à un volume plus important. Avec 1 000 investisseurs, le même comportement peut conduire à 1 001 requêtes dans le scénario considéré.
Le problème n’est donc pas simplement le nombre d’instructions présentes dans le code Java. Il faut également comprendre le nombre réel de requêtes SQL générées par Hibernate et les échanges nécessaires avec la base de données.
C’est pourquoi l’analyse des performances d’une application utilisant JPA ne doit pas se limiter à la lecture du code métier. Il est nécessaire d’observer le comportement réel de la couche de persistance.
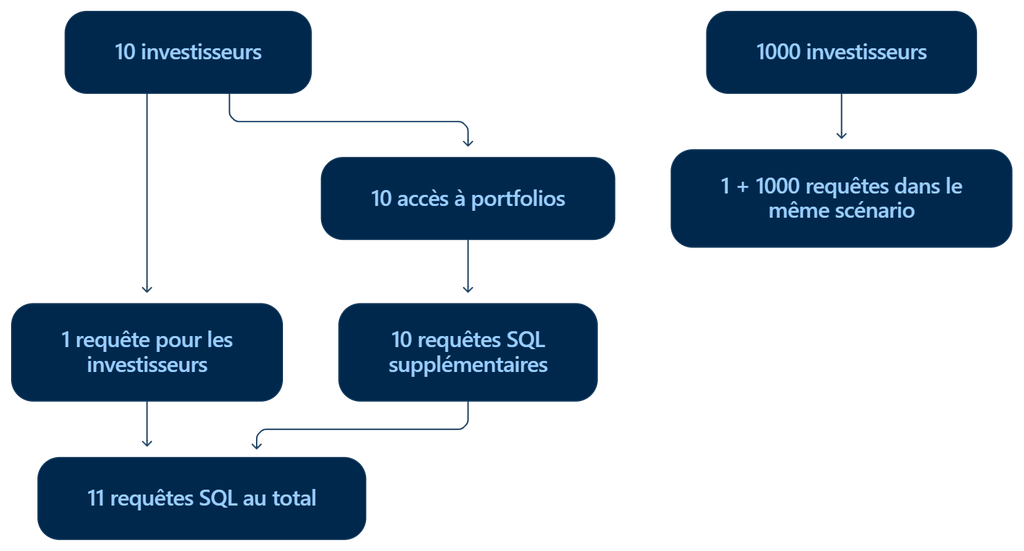
Dans notre expérience, le comportement peut être résumé ainsi :
1 requête pour récupérer les investisseurs + 1 requête par investisseur pour récupérer ses portefeuilles.
Pour 10 investisseurs, Hibernate exécute donc 11 requêtes SQL.
Cette observation constitue notre point de départ. L’objectif des sections suivantes sera de réduire cette multiplication des requêtes tout en conservant un comportement de chargement adapté au cas d’usage.
| Nombre d’investisseurs | Requête initiale | Requêtes supplémentaires | Total |
|---|---|---|---|
| 10 | 1 | 10 | 11 |
| 100 | 1 | 100 | 101 |
| 1 000 | 1 | 1 000 | 1 001 |
2. La solution 1 : le Batch Fetching
Le Lazy Loading permet d’éviter de charger systématiquement les associations d’une entité, mais il ne suffit pas à lui seul à empêcher le problème N+1. Lorsque plusieurs associations différées doivent être initialisées au cours d’un même traitement, Hibernate peut multiplier les requêtes SQL.
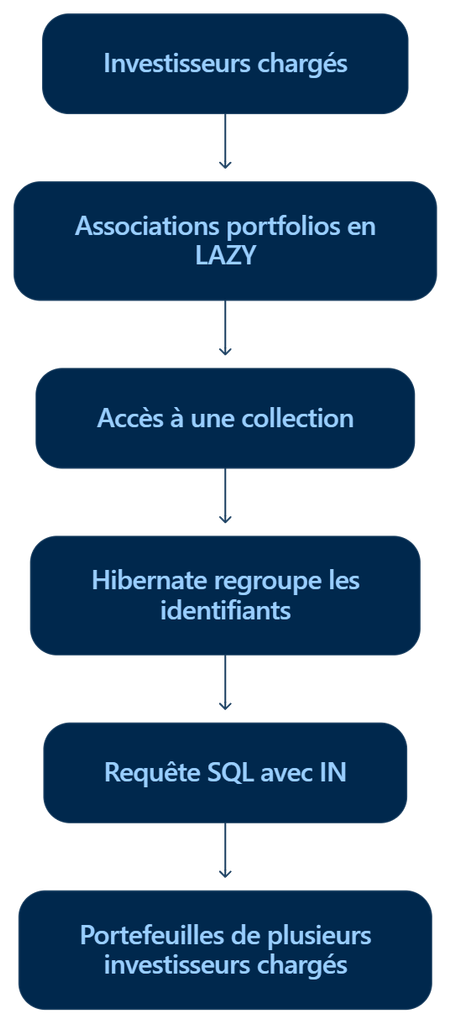
Le Batch Fetching apporte une approche différente. Au lieu de charger chaque association individuellement, Hibernate regroupe plusieurs chargements dans une même requête SQL.
L’application conserve ainsi le principe du chargement différé : les portefeuilles ne sont toujours pas chargés au moment où les investisseurs sont récupérés. La différence intervient lorsque l’une de ces associations doit être initialisée. Hibernate peut alors profiter des autres associations différées présentes dans le contexte de persistance pour effectuer un chargement groupé.
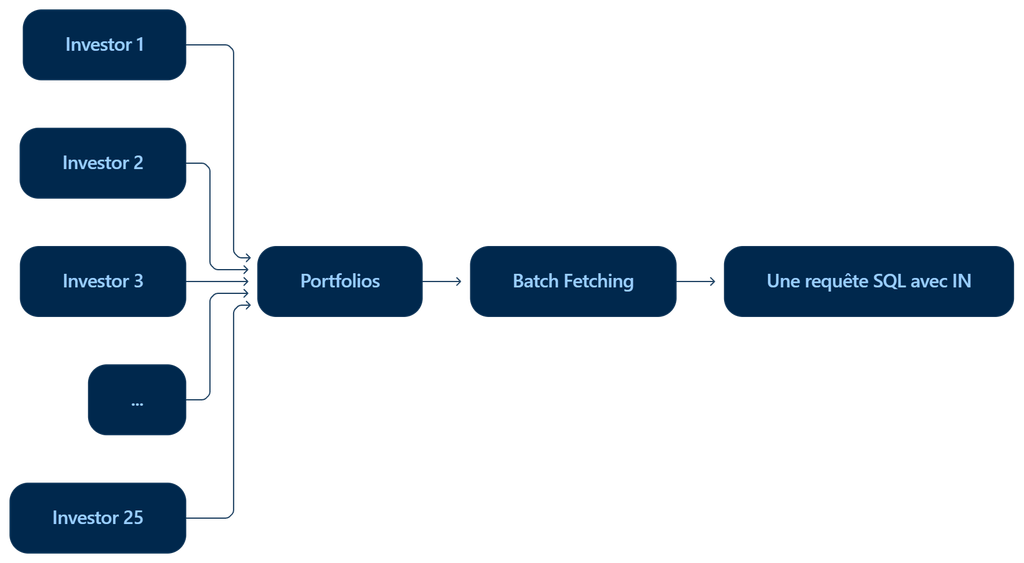
Dans notre scénario, au lieu d’exécuter une requête distincte pour chaque investisseur, Hibernate peut récupérer les portefeuilles de plusieurs investisseurs à l’aide d’une seule requête utilisant une clause IN.
Le nombre de requêtes nécessaires diminue donc considérablement, tout en conservant le comportement Lazy de l’association.
2.1. Comment fonctionne le Batch Fetching ?
Le principe du Batch Fetching consiste à regrouper plusieurs chargements différés afin d’éviter qu’Hibernate n’exécute une requête SQL distincte pour chaque association.
Lorsqu’une association LAZY doit être initialisée, Hibernate peut identifier plusieurs entités du même type dont les associations correspondantes ne sont pas encore chargées. Plutôt que d’interroger la base de données pour une seule entité, il regroupe plusieurs identifiants et construit une requête utilisant une clause IN.
Dans notre exemple, au lieu d’obtenir une succession de requêtes comme :
WHERE investor_id = 1
WHERE investor_id = 2
WHERE investor_id = 3
...
Hibernate peut regrouper plusieurs identifiants dans une seule requête :
WHERE investor_id IN (1, 2, 3, ...)
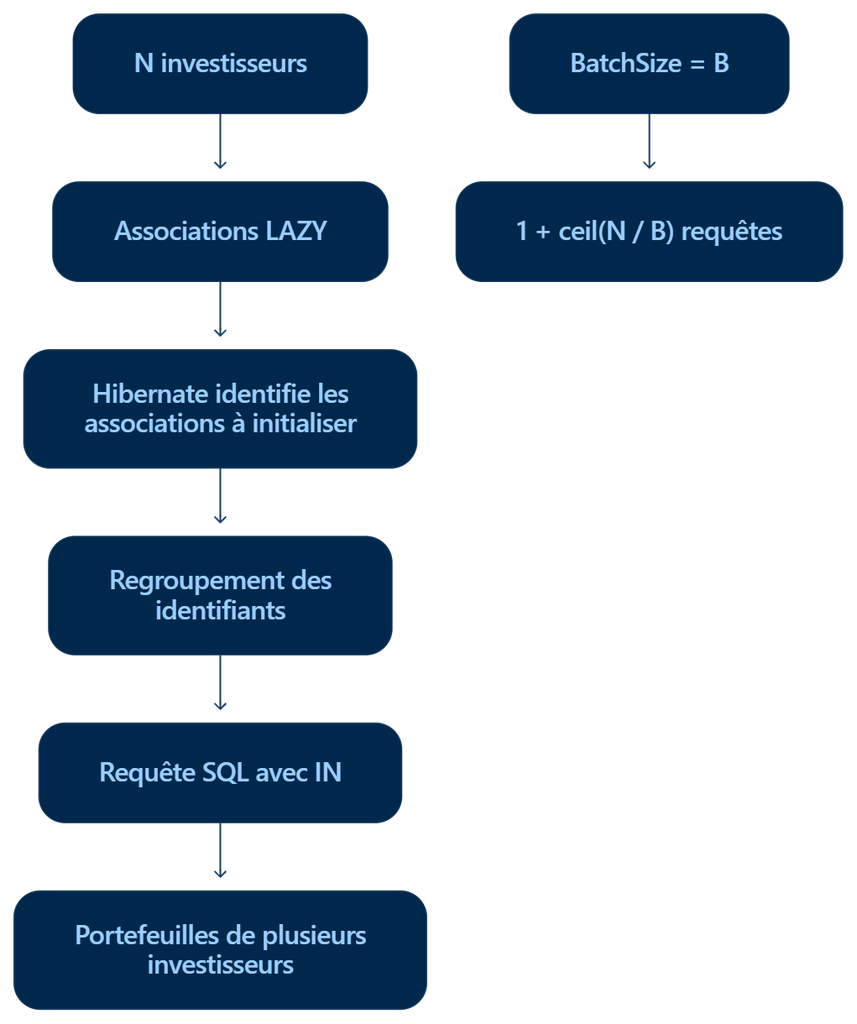
Le nombre de requêtes dépend alors du nombre d’entités à charger et de la taille du lot configurée.
Pour un ensemble de N entités et une taille de lot de B, le nombre de requêtes nécessaires pour charger les associations peut être approximativement représenté par :
1 + ⌈ N / B ⌉
La première requête récupère les entités principales. Les requêtes suivantes récupèrent les associations par groupes.
Dans notre scénario, si Hibernate doit charger les portefeuilles de plusieurs investisseurs, la requête peut prendre la forme suivante :
SELECT
id,
name,
investor_id
FROM
t_portfolios
WHERE
investor_id IN (?, ?, ?, ?, ?, ?, ?, ?, ?, ?);Prenons notre scénario avec 10 investisseurs et une taille de lot de 25.
Hibernate peut charger les portefeuilles des 10 investisseurs dans un seul lot. Nous obtenons alors :
1 requête pour les investisseurs + 1 requête pour les portefeuilles = 2 requêtes SQL.
Avec un volume plus important, la taille du lot devient déterminante. Par exemple, avec 100 investisseurs et une taille de lot de 25, les associations peuvent être chargées en plusieurs groupes plutôt que par une requête individuelle pour chaque investisseur.
Le Batch Fetching permet ainsi de réduire fortement le nombre d’allers-retours vers la base de données tout en conservant le principe du Lazy Loading.
2.2. Configurer le Batch Fetching avec @BatchSize
Hibernate permet de contrôler le Batch Fetching directement au niveau d’une association grâce à l’annotation @BatchSize.
Cette approche permet de définir une taille de lot spécifique pour une association donnée. Dans notre exemple, nous pouvons indiquer à Hibernate de regrouper jusqu’à 25 identifiants lors du chargement des portefeuilles.
L’association conserve son comportement LAZY. La différence est que lorsqu’Hibernate doit initialiser plusieurs collections similaires, il peut les regrouper afin de réduire le nombre de requêtes SQL envoyées à la base de données.
Cette configuration est particulièrement intéressante lorsque nous voulons optimiser une association précise sans modifier le comportement de l’ensemble des associations de l’application.
@OneToMany(
mappedBy = "investor",
fetch = FetchType.LAZY
)
@BatchSize(size = 25)
private List<Portfolio> portfolios = new ArrayList<>();L’élément important ici est @BatchSize(size = 25).
Cette configuration indique à Hibernate qu’il peut regrouper les chargements par lots allant jusqu’à 25 éléments. Elle ne transforme pas l’association en chargement immédiat et ne signifie pas non plus qu’Hibernate exécutera systématiquement exactement 25 chargements.
La taille du lot constitue donc un paramètre d’optimisation. Elle doit être choisie en fonction du comportement réel de l’application, du volume de données et des caractéristiques de la base de données.
L’intérêt principal de cette configuration est de réduire le nombre d’allers-retours vers la base tout en conservant le principe du Lazy Loading.
SELECT
id,
name,
investor_id
FROM
t_portfolios
WHERE
investor_id IN (?, ?, ?, ?, ?, ?, ?, ?, ?, ?);2.3. Configurer le Batch Fetching globalement
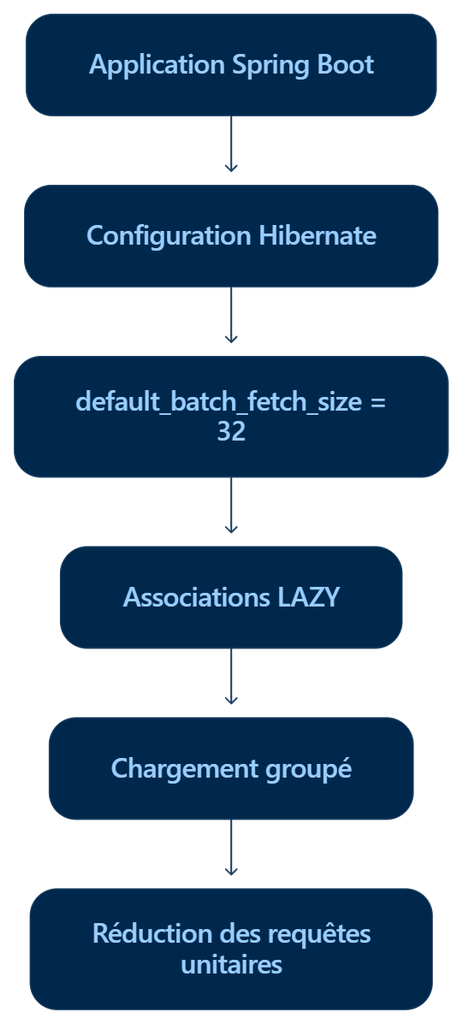
La configuration de @BatchSize au niveau d’une association permet de cibler précisément une relation. Hibernate propose également une configuration globale permettant d’appliquer le Batch Fetching aux associations différées de l’application.
Cette configuration s’effectue avec la propriété hibernate.default_batch_fetch_size.
Elle permet de définir une taille de lot par défaut pour le chargement groupé des associations et des entités différées. L’intérêt est d’éviter de devoir ajouter systématiquement @BatchSize sur chaque association que l’on souhaite optimiser.
Dans notre exemple, nous pouvons définir une taille de lot globale de 32.
spring:
jpa:
properties:
hibernate:
default_batch_fetch_size: 32Avec cette configuration, Hibernate dispose d’une taille de lot par défaut de 32 lorsqu’il effectue certains chargements groupés.
Cette approche constitue un mécanisme de protection intéressant dans une application comportant de nombreuses associations LAZY. Elle permet de réduire le risque qu’un simple parcours d’entités déclenche une longue succession de requêtes unitaires.
Il faut toutefois considérer cette configuration comme un mécanisme d’optimisation global et non comme un remplacement de la conception explicite des requêtes. Le choix de la taille du lot doit être adapté au comportement réel de l’application et vérifié à l’aide de mesures.
La configuration globale et @BatchSize peuvent ainsi répondre à deux besoins différents : la première fournit une politique générale, tandis que la seconde permet un réglage ciblé sur une association particulière.
2.4. Résultat du Batch Fetching dans notre expérience
Dans notre scénario de test, nous avons utilisé 10 investisseurs, chacun pouvant posséder plusieurs portefeuilles. Avec le chargement LAZY sans stratégie de batch, l’accès aux portefeuilles provoquait une requête SQL supplémentaire pour chaque investisseur.
Avec un @BatchSize(size = 25), Hibernate regroupe les identifiants des entités à charger et récupère les portefeuilles correspondants dans une seule requête utilisant une clause IN.
Pour nos 10 investisseurs, le résultat passe ainsi de 11 requêtes SQL à 2 requêtes SQL : une première requête pour récupérer les investisseurs, puis une seconde pour récupérer leurs portefeuilles par lots.
Le Batch Fetching permet donc de conserver le chargement LAZY tout en réduisant fortement le nombre de requêtes générées par Hibernate.
Requête initiale :
SELECT id, name
FROM t_investors;Requête groupée générée pour les portefeuilles :
SELECT
    id,
    name,
    investor_id
FROM
    t_portfolios
WHERE
    investor_id IN (?, ?, ?, ?, ?, ?, ?, ?, ?, ?);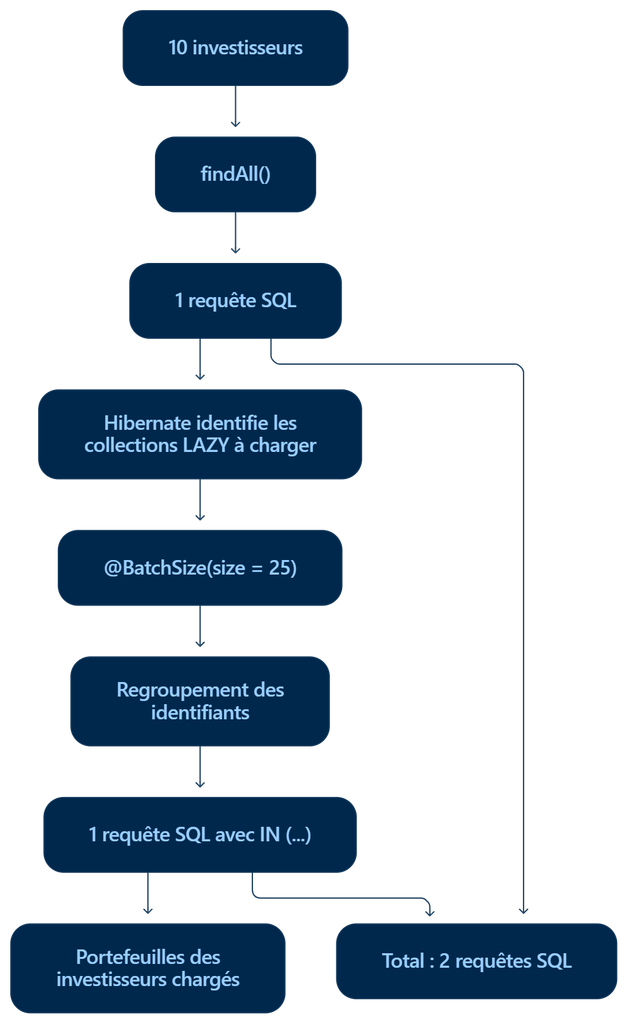
3. La solution 2 : JOIN FETCH
Le Batch Fetching réduit fortement le nombre de requêtes SQL tout en conservant le chargement LAZY. Cependant, dans certains cas, nous savons dès la conception du cas d’utilisation que les données associées sont nécessaires.
C’est notamment le cas lorsque notre service doit retourner les investisseurs avec leurs portefeuilles dans une même opération.
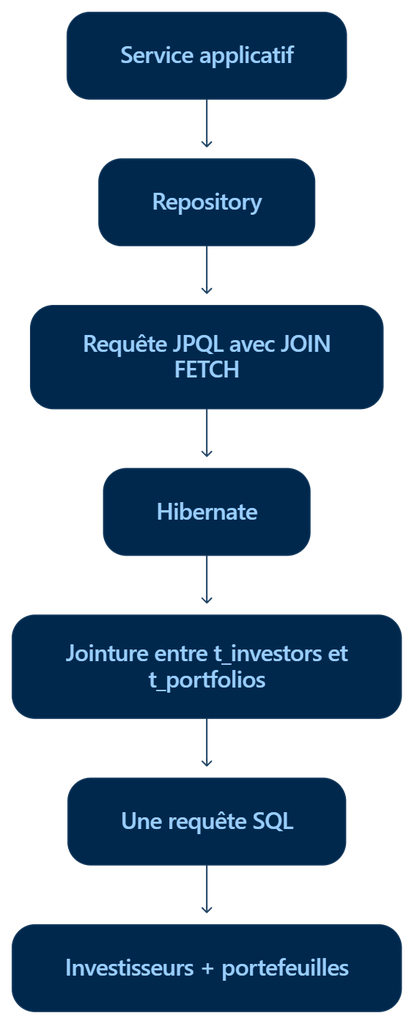
Dans cette situation, nous pouvons demander explicitement à Hibernate de charger l’association dans la requête initiale grâce à JOIN FETCH.
L’idée est différente du Batch Fetching : au lieu de récupérer les associations dans une requête supplémentaire regroupée par lots, nous demandons à Hibernate de récupérer les investisseurs et leurs portefeuilles dans une seule requête SQL basée sur une jointure.
3.1. Comment fonctionne JOIN FETCH ?
JOIN FETCH permet d’indiquer explicitement à Hibernate qu’une association doit être chargée dans le cadre de la requête principale.
Dans notre cas, nous récupérons les investisseurs et leurs portefeuilles au moyen d’une même requête JPQL. Hibernate traduit ensuite cette requête en SQL avec une jointure entre les tables t_investors et t_portfolios.
L’intérêt principal est que lorsque le service accède ensuite à investor.getPortfolios(), les données ont déjà été chargées dans le contexte de persistance. Hibernate n’a donc pas besoin d’exécuter une nouvelle requête SQL pour chaque investisseur.
Contrairement au Batch Fetching, qui regroupe les requêtes de chargement des associations, JOIN FETCH fait directement participer l’association à la requête initiale.
Requête JPQL :
@Query("SELECT DISTINCT i FROM Investor i LEFT JOIN FETCH i.portfolios")
List<Investor> findAllWithPortfoliosByJoinFetch();SQL généré
SELECT
i.id,
i.name,
p.id,
p.name,
p.investor_id
FROM
t_investors i
LEFT OUTER JOIN
t_portfolios p
ON i.id = p.investor_id;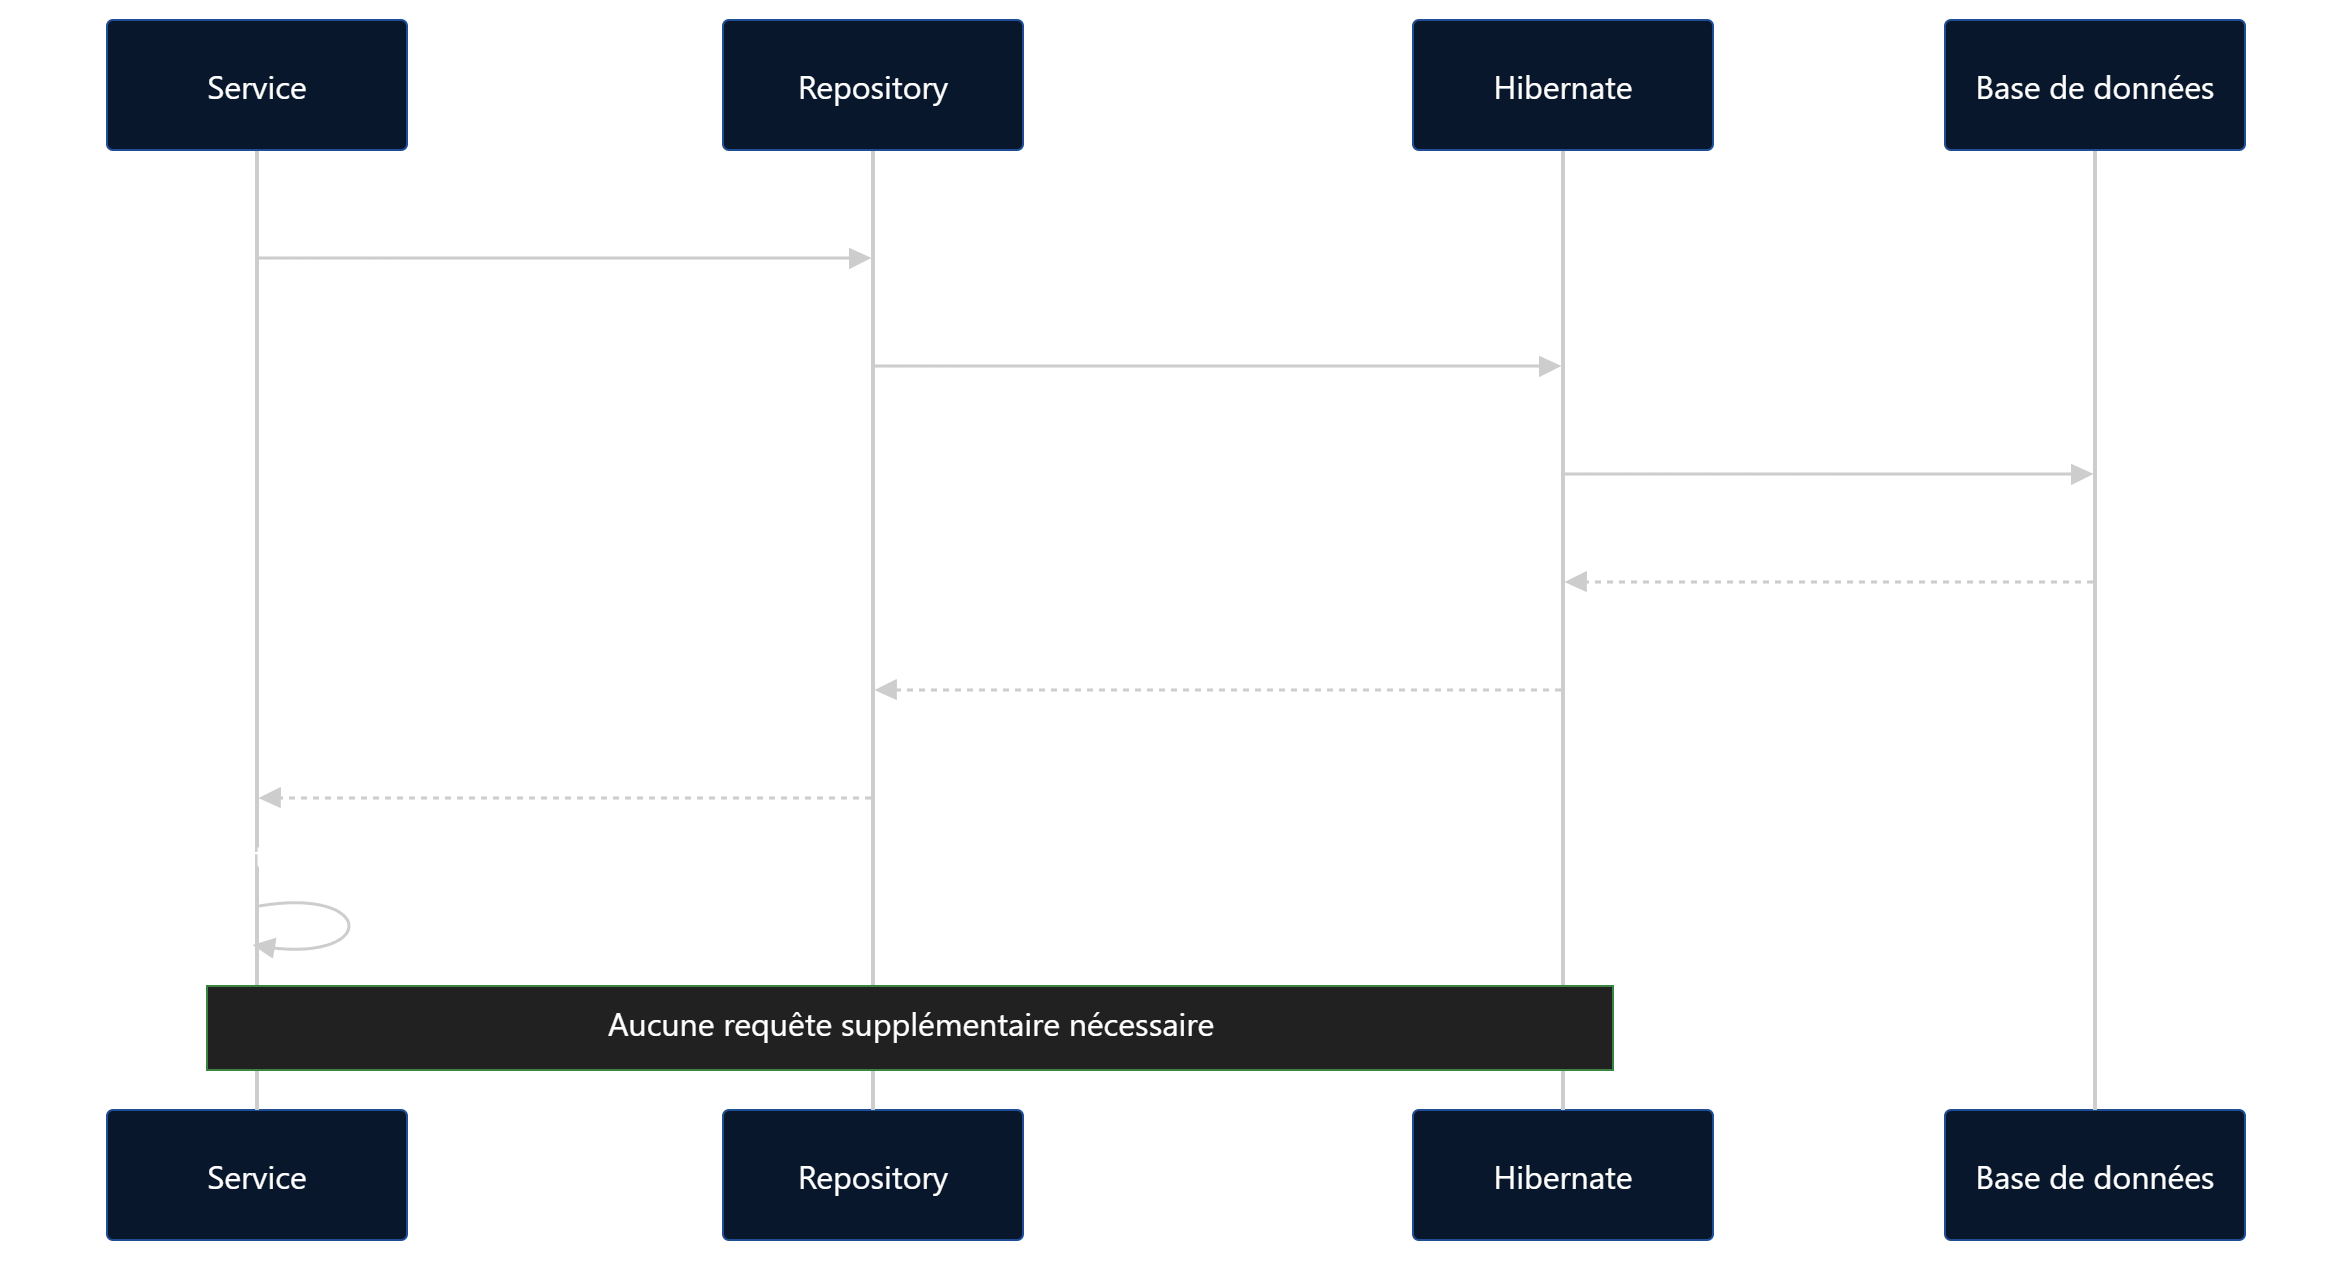
3.2. Implémenter JOIN FETCH avec Spring Data JPA
Avec Spring Data JPA, l’implémentation de JOIN FETCH peut être réalisée directement dans le repository à l’aide de l’annotation @Query.
Dans notre exemple, le repository InvestorRepository expose une méthode dédiée au cas d’utilisation qui nécessite le chargement des portefeuilles avec les investisseurs.
Cette approche permet de conserver une définition de relation LAZY dans l’entité tout en contrôlant explicitement les données chargées pour une requête particulière.
package com.aroolia.performance.batchfetching.repository;
import com.aroolia.performance.batchfetching.model.Investor;
import org.springframework.data.jpa.repository.JpaRepository;
import org.springframework.data.jpa.repository.Query;
import java.util.List;
public interface InvestorRepository extends JpaRepository<Investor, Long> {
@Query("SELECT DISTINCT i FROM Investor i LEFT JOIN FETCH i.portfolios")
List<Investor> findAllWithPortfoliosByJoinFetch();
}La jointure entre Investor et Portfolio peut produire plusieurs lignes SQL pour un même investisseur lorsqu’il possède plusieurs portefeuilles.
Par exemple, un investisseur possédant deux portefeuilles apparaîtra sur deux lignes du résultat SQL, une pour chaque portefeuille.
Le DISTINCT dans la requête JPQL permet de demander à Hibernate de retourner chaque entité Investor une seule fois dans le résultat final, tout en conservant les différents portefeuilles associés dans sa collection.
Il faut donc distinguer le résultat de la jointure SQL et le résultat des entités retournées par Hibernate : une jointure peut produire plusieurs lignes pour un même investisseur, alors que la collection Java finale contient un seul objet Investor avec ses différents Portfolio.

3.3. JOIN FETCH avec une association LAZY
Une question revient souvent lorsqu’on découvre JOIN FETCH : faut-il modifier l’association @OneToMany et remplacer FetchType.LAZY par FetchType.EAGER ?
Dans notre cas, la réponse est non.
Nous conservons l’association en LAZY. Cela signifie que, par défaut, Hibernate ne charge pas automatiquement les portefeuilles lorsque les investisseurs sont récupérés.
JOIN FETCH permet ensuite de modifier ce comportement uniquement pour la requête qui en a besoin. La requête du repository demande explicitement à Hibernate de charger les portefeuilles avec les investisseurs.
Cette distinction est importante pour la conception d’une application. Le mapping de l’entité définit le comportement général de la relation, tandis que la requête permet d’adapter le chargement au besoin du cas d’utilisation.
Nous évitons ainsi de transformer globalement une association en EAGER simplement parce qu’un écran ou un service particulier a besoin des données associées.
Mapping de l’association:
@OneToMany(
mappedBy = "investor",
fetch = FetchType.LAZY,
cascade = CascadeType.ALL,
orphanRemoval = true
)
private List<Portfolio> portfolios = new ArrayList<>();Requête utilisant JOIN FETCH
@Query("""
SELECT DISTINCT i
FROM Investor i
LEFT JOIN FETCH i.portfolios
""")
List<Investor> findAllWithPortfoliosByJoinFetch();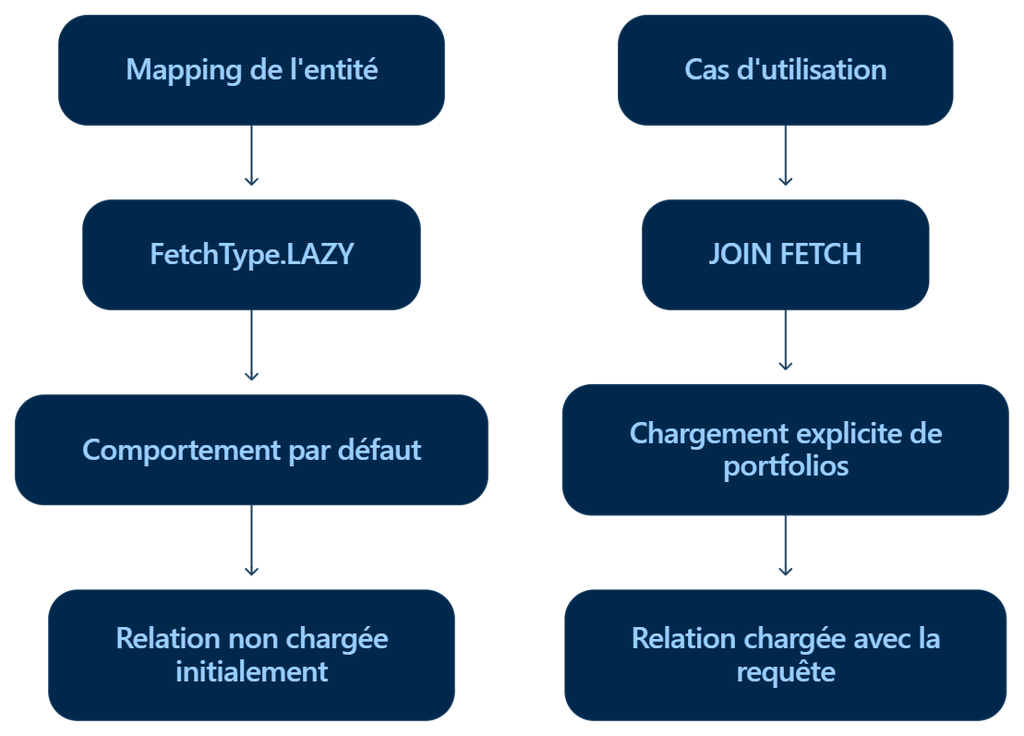
Utiliser FetchType.EAGER comme réponse générale au problème du N+1 n’est donc pas une stratégie suffisamment précise. Cela modifierait le comportement de la relation pour toutes les requêtes qui chargent Investor, y compris celles qui n’ont pas besoin des portefeuilles.
Avec LAZY associé à JOIN FETCH, nous conservons au contraire un contrôle explicite du chargement des données.
L’idée n’est pas de dire que LAZY est toujours préférable dans tous les contextes, mais de montrer que le chargement des associations peut être piloté en fonction du besoin réel de chaque cas d’utilisation.
3.4. Le service optimisé avec JOIN FETCH
Une fois la méthode JOIN FETCH définie dans le repository, le service peut l’utiliser directement pour récupérer les investisseurs avec leurs portefeuilles déjà chargés.
Le reste du traitement métier reste identique à celui utilisé dans notre scénario avec le N+1. La différence se situe dans la manière dont les données sont récupérées par la couche de persistance.
Le service demande donc au repository une liste d’investisseurs optimisée, puis construit les PortfolioSummary à partir des données déjà disponibles.
@Transactional(readOnly = true)
public List<PortfolioSummary> getInvestorSummariesWithJoinFetch() {
List<Investor> investors =
investorRepository.findAllWithPortfoliosByJoinFetch();
return investors.stream()
.map(investor -> new PortfolioSummary(
investor.getName(),
investor.getPortfolios().size()
))
.collect(Collectors.toList());
}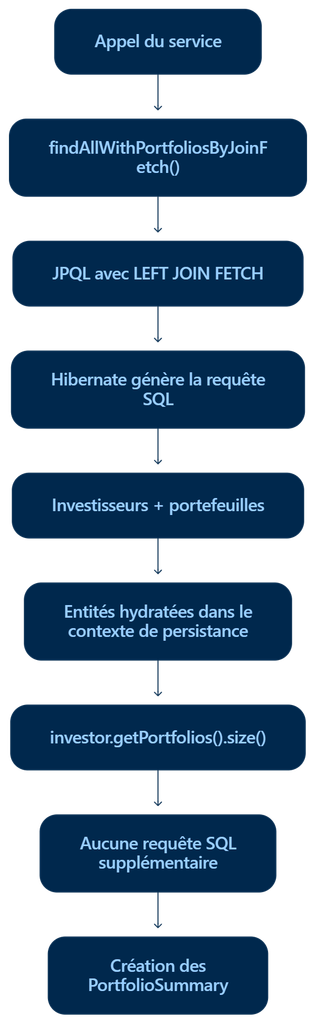
Dans notre scénario de test avec 10 investisseurs, JOIN FETCH permet de récupérer les investisseurs et leurs portefeuilles avec une seule requête SQL.
Le traitement métier ne déclenche donc plus une requête supplémentaire lorsqu’il accède à investor.getPortfolios().
Nous obtenons ainsi le même résultat fonctionnel que dans l’approche précédente, mais avec une stratégie de chargement différente : le graphe nécessaire au cas d’utilisation est récupéré dès la requête initiale.
3.5. Les limites de JOIN FETCH
JOIN FETCH permet de réduire le nombre de requêtes SQL à une seule dans notre scénario, mais cela ne signifie pas qu’il s’agit systématiquement de la meilleure stratégie.
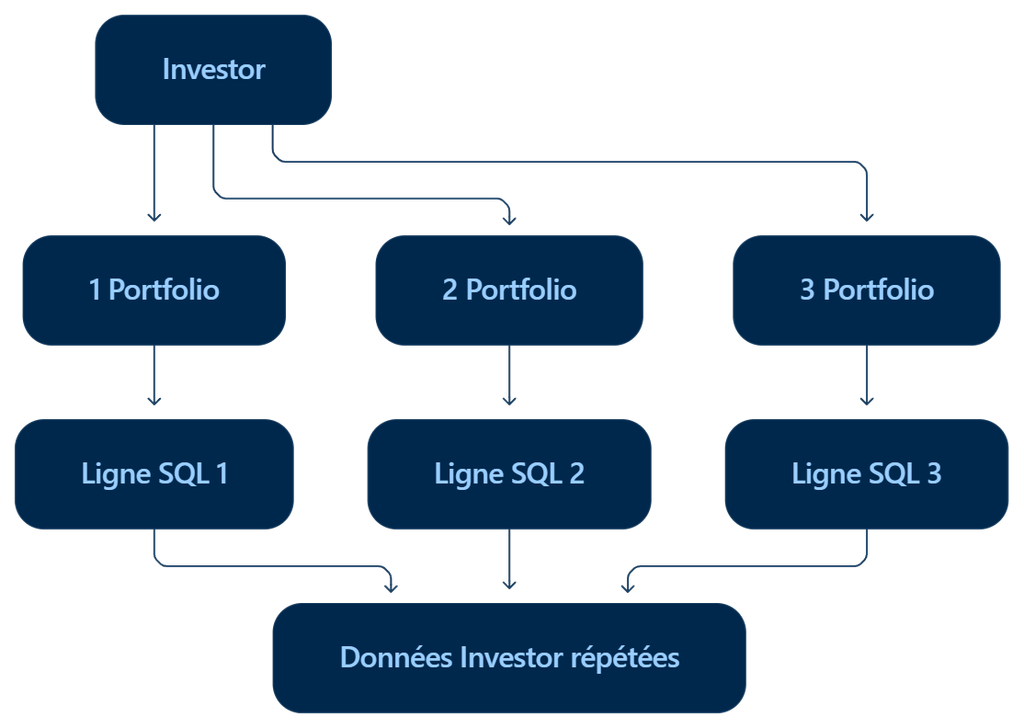
La première limite concerne le volume de données retourné par la jointure. Lorsqu’un investisseur possède plusieurs portefeuilles, les informations de l’investisseur sont répétées sur plusieurs lignes du résultat SQL. Plus le graphe d’objets devient important, plus le volume de données transféré et traité peut augmenter.
Cette situation devient particulièrement problématique lorsque plusieurs collections sont chargées simultanément. Avec plusieurs associations de type List, Hibernate peut notamment rencontrer une MultipleBagFetchException.
Le choix de JOIN FETCH doit donc rester lié au cas d’utilisation. Une requête qui doit réellement récupérer un graphe complet peut tirer un grand bénéfice de cette approche. En revanche, utiliser systématiquement des jointures pour charger de grandes collections peut produire une requête lourde et augmenter la consommation mémoire.
Dans une application d’entreprise, l’objectif n’est donc pas simplement de réduire le nombre de requêtes SQL. Il faut également contrôler le volume de données récupéré, la complexité des jointures et la structure du graphe d’objets.
Effet de la jointure sur le résultat SQL
SELECT
i.id,
i.name,
p.id,
p.name,
p.investor_id
FROM t_investors i
LEFT OUTER JOIN t_portfolios p
ON i.id = p.investor_id;Dans notre modèle, un investisseur possédant deux portefeuilles peut donc produire deux lignes dans le résultat de la jointure. Hibernate doit ensuite reconstruire le graphe d’objets à partir de ces lignes.
C’est précisément pour cette raison que JOIN FETCH doit être utilisé avec discernement. Son avantage est évident lorsque le volume du graphe reste maîtrisé et que les données associées sont réellement nécessaires au cas d’utilisation.
Lorsque les collections sont volumineuses ou que plusieurs associations doivent être récupérées simultanément, le Batch Fetching peut constituer une alternative plus contrôlable.
4. La solution 3 : @EntityGraph avec Spring Data JPA
JOIN FETCH n’est pas la seule manière de contrôler explicitement le chargement d’une association avec Spring Data JPA. Une autre approche consiste à utiliser @EntityGraph.
@EntityGraph permet de déclarer les associations qui doivent être chargées lors de l’exécution d’une requête, sans écrire explicitement le JOIN FETCH dans la requête JPQL.
Cette approche est particulièrement intéressante lorsque nous voulons conserver une requête repository simple tout en déclarant clairement le graphe d’entités nécessaire à un cas d’utilisation donné.
Dans notre exemple, nous pouvons demander à Spring Data JPA de charger l’association portfolios avec les investisseurs en utilisant @EntityGraph(attributePaths = {"portfolios"}).
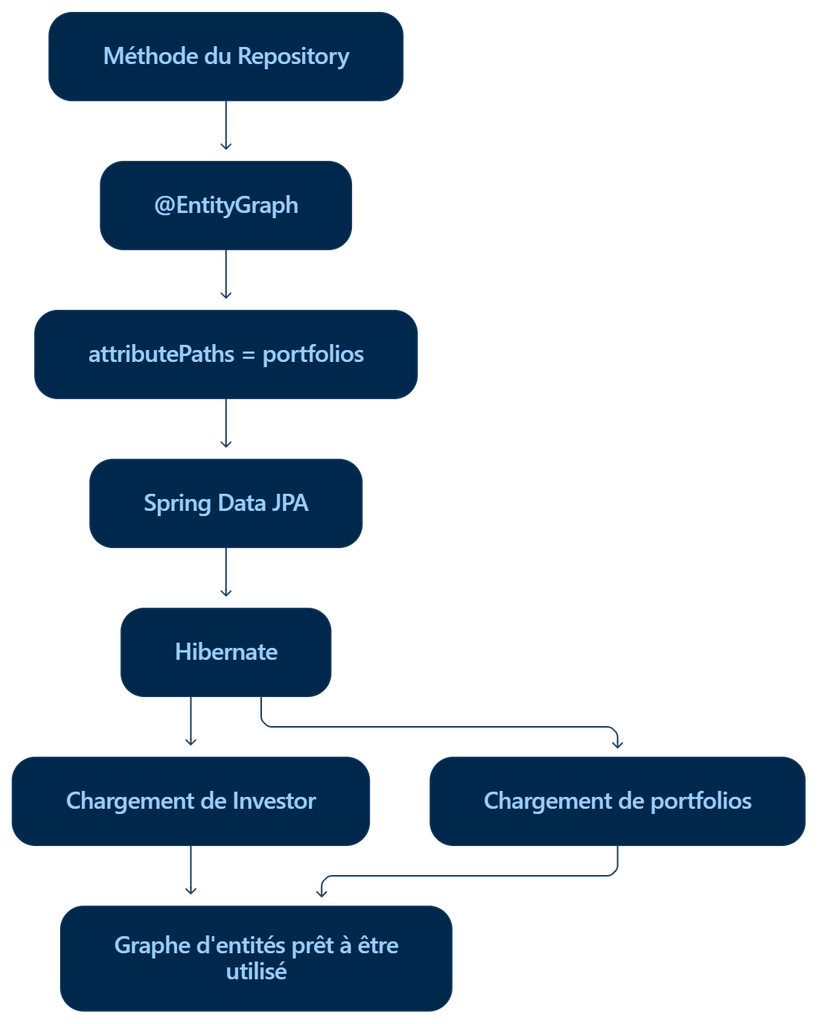
@EntityGraph(attributePaths = {"portfolios"})
@Query("SELECT i FROM Investor i")
List<Investor> findAllWithPortfoliosByEntityGraph();L’intérêt de cette approche est de séparer davantage la requête du graphe de chargement.
La requête JPQL exprime ici que nous souhaitons récupérer les investisseurs, tandis que @EntityGraph indique que l’association portfolios fait partie du graphe à charger pour cette opération.
Nous obtenons ainsi une solution plus déclarative que JOIN FETCH, tout en conservant la possibilité de choisir précisément quelles associations doivent être récupérées pour chaque méthode du repository.
4.1. Comment fonctionne @EntityGraph ?
@EntityGraph permet de définir, pour une méthode de repository donnée, quelles associations doivent être chargées avec l’entité principale.
Dans notre exemple, nous déclarons portfolios dans attributePaths. Spring Data JPA utilise alors cette information pour demander au fournisseur JPA de charger cette association dans le cadre de l’exécution de la requête.
L’intérêt est de pouvoir conserver le mapping FetchType.LAZY dans l’entité Investor tout en définissant un graphe de chargement spécifique pour cette méthode.
Nous obtenons donc une séparation claire entre deux responsabilités : le mapping décrit le comportement général de l’association, tandis que l’EntityGraph décrit les données nécessaires à une opération particulière.
@EntityGraph(attributePaths = {"portfolios"})
@Query("SELECT i FROM Investor i")
List<Investor> findAllWithPortfoliosByEntityGraph();Correspondance entre la requête et le graphe
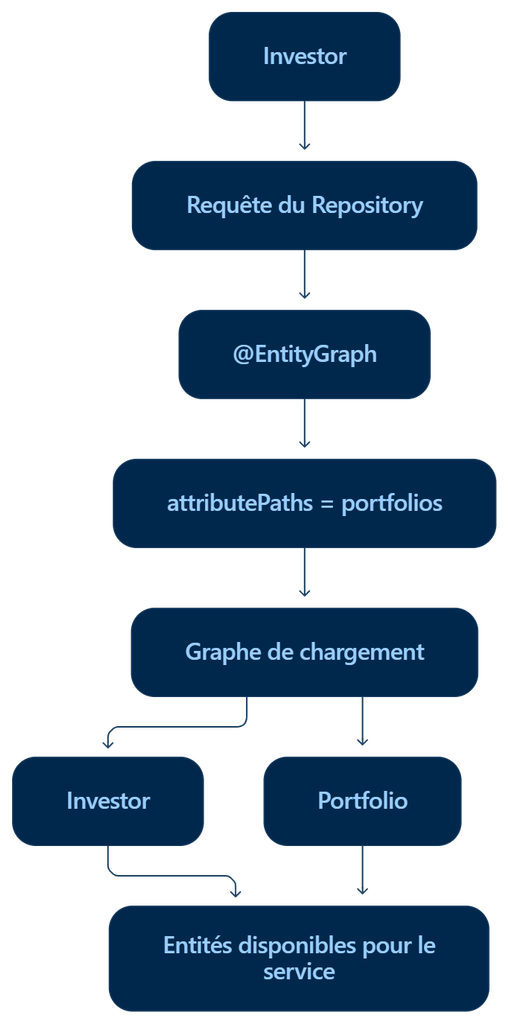
Dans notre exemple, @EntityGraph répond au même besoin fonctionnel que la méthode JOIN FETCH présentée précédemment : récupérer les investisseurs avec leurs portefeuilles afin d’éviter le déclenchement de requêtes supplémentaires lors de l’accès à la collection.
La différence principale réside dans la manière d’exprimer cette intention. Avec JOIN FETCH, le chargement de l’association est directement exprimé dans la requête JPQL. Avec @EntityGraph, le graphe de chargement est déclaré séparément de la requête.
Cette approche peut rendre certaines méthodes de repository plus lisibles lorsque plusieurs variantes de graphes doivent être définies selon les cas d’utilisation.
4.2. Implémenter @EntityGraph dans InvestorRepository
Dans Spring Data JPA, @EntityGraph s’utilise directement sur une méthode de repository. Il suffit de préciser dans attributePaths les associations qui doivent faire partie du graphe chargé.
Dans notre cas, nous déclarons portfolios afin que les portefeuilles soient récupérés avec les investisseurs lors de l’exécution de la méthode.
Nous pouvons ainsi conserver une requête JPQL très simple, sans écrire explicitement la jointure dans celle-ci.
Code du repository/
package com.aroolia.performance.batchfetching.repository;
import com.aroolia.performance.batchfetching.model.Investor;
import org.springframework.data.jpa.repository.EntityGraph;
import org.springframework.data.jpa.repository.JpaRepository;
import org.springframework.data.jpa.repository.Query;
import java.util.List;
public interface InvestorRepository extends JpaRepository<Investor, Long> {
@EntityGraph(attributePaths = {"portfolios"})
@Query("SELECT i FROM Investor i")
List<Investor> findAllWithPortfoliosByEntityGraph();
}Fonctionnement:
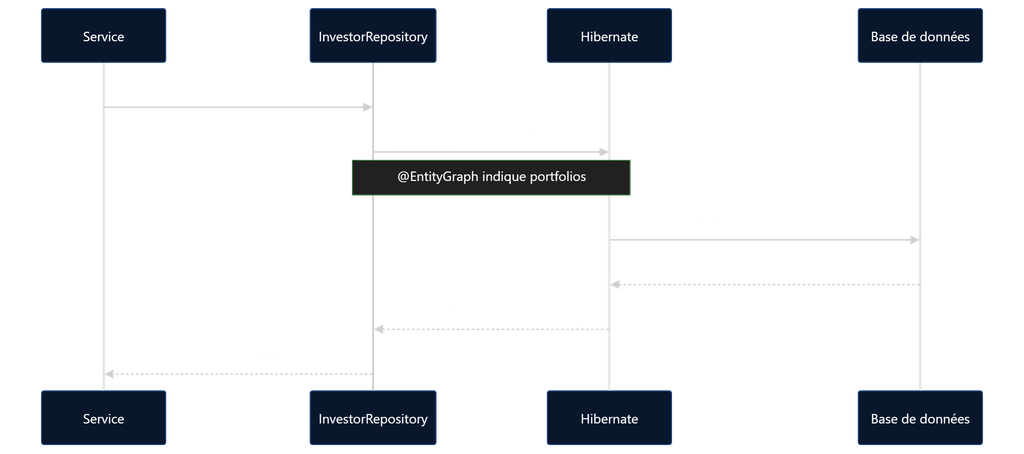
Dans notre projet, @EntityGraph constitue donc une alternative déclarative à JOIN FETCH. Les deux approches permettent de demander le chargement de portfolios dans le cadre de cette opération, mais l’intention est exprimée différemment.
Avec JOIN FETCH, la stratégie de chargement est directement visible dans la requête JPQL. Avec @EntityGraph, elle est déclarée à côté de la requête, au niveau de la méthode du repository.
Cette différence peut sembler mineure sur un exemple simple. Elle devient cependant intéressante lorsque l’application possède plusieurs cas d’utilisation nécessitant des graphes de chargement différents.
4.3. @EntityGraph vs JOIN FETCH : quelle différence ?
Dans notre cas, @EntityGraph et JOIN FETCH répondent au même besoin : charger les investisseurs avec leurs portefeuilles afin d’éviter le déclenchement de requêtes supplémentaires lors de l’accès à la collection.
La principale différence concerne la manière dont cette intention est exprimée.
Avec JOIN FETCH, le développeur décrit explicitement la stratégie de chargement dans la requête JPQL. La jointure fait donc partie intégrante de la requête :
SELECT DISTINCT i FROM Investor i LEFT JOIN FETCH i.portfoliosAvec @EntityGraph, la requête reste indépendante de la stratégie de chargement et le graphe d’entités est déclaré séparément :
@EntityGraph(attributePaths = {"portfolios"})Pour un cas simple, les deux approches peuvent donc produire un résultat très proche. Le choix dépend surtout de la lisibilité recherchée, de la complexité de la requête et de la manière dont l’équipe souhaite exprimer les besoins de chargement.
| Critère | JOIN FETCH | @EntityGraph |
|---|---|---|
| Déclaration du chargement | Dans la requête JPQL | Via une annotation |
| Contrôle du graphe | Explicite dans la requête | Déclaratif |
| Requête JPQL | Plus détaillée | Plus simple |
| Lisibilité | Très explicite sur la jointure | Séparation requête / chargement |
| Standard JPA | Oui | Oui |
| Cas d’utilisation | Requêtes complexes et contrôle précis | Graphes de chargement déclaratifs |
Exemple:
// Avec JOIN FETCH
@Query("""
SELECT DISTINCT i
FROM Investor i
LEFT JOIN FETCH i.portfolios
""")
List<Investor> findAllWithPortfoliosByJoinFetch();// Avec @EntityGraph
@EntityGraph(attributePaths = {"portfolios"})
@Query("SELECT i FROM Investor i")
List<Investor> findAllWithPortfoliosByEntityGraph();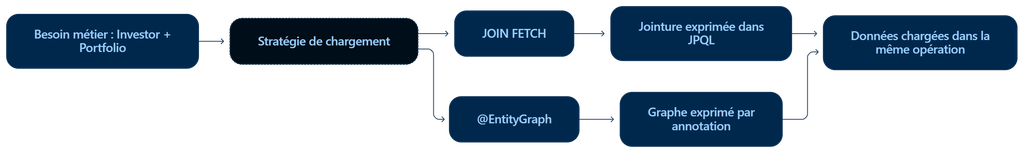
Dans notre projet, les deux solutions permettent donc d’exprimer le même besoin de chargement, mais elles ne doivent pas être considérées comme deux mécanismes fondamentalement opposés.
JOIN FETCH est particulièrement intéressant lorsque la requête elle-même doit exprimer précisément les jointures nécessaires au cas d’utilisation.
@EntityGraph est intéressant lorsque nous souhaitons conserver une requête relativement simple tout en déclarant explicitement les associations nécessaires au chargement.
Dans les deux cas, la décision doit partir du cas d’utilisation et du volume réel de données à récupérer, plutôt que de chercher une règle universelle du type « toujours utiliser JOIN FETCH » ou « toujours utiliser EntityGraph ».
5. Comparatif technique : Batch Fetching vs JOIN FETCH vs @EntityGraph
Les trois approches étudiées répondent au même problème général, mais elles ne fonctionnent pas de la même manière.
Le JOIN FETCH permet de charger explicitement une association dans la requête principale. @EntityGraph permet de déclarer le graphe d’entités nécessaire à une méthode du repository. Le Batch Fetching, quant à lui, conserve le chargement différé et regroupe les chargements des associations lorsqu’elles sont effectivement demandées.
Dans notre scénario avec 10 investisseurs, les tests montrent une différence nette sur le nombre de requêtes SQL : le Lazy Loading sans optimisation produit 11 requêtes, le Batch Fetching en produit 2 et le JOIN FETCH en produit 1.
Le nombre de requêtes n’est cependant pas le seul critère à prendre en compte. Le volume de données transféré, la complexité des jointures, le comportement du chargement LAZY et la structure du graphe d’objets doivent également entrer dans la décision.
Tableau comparatif
| Critère | Lazy Loading sans optimisation | Batch Fetching | JOIN FETCH | @EntityGraph |
|---|---|---|---|---|
| Nombre de requêtes dans notre test | 11 | 2 | 1 | Comparable à JOIN FETCH selon le plan généré |
| Chargement différé | Oui | Oui | Non pour l’association ciblée | Non pour l’association ciblée |
| Principe | Une requête par association sollicitée | Regroupement des chargements | Jointure dans la requête | Graphe de chargement déclaré |
| Configuration | Aucune | @BatchSize ou configuration Hibernate | JPQL | Annotation JPA |
| Contrôle par cas d’utilisation | Faible | Moyen | Élevé | Élevé |
| Risque de résultat SQL volumineux | Faible | Modéré | Plus important avec de grandes collections | Dépend du graphe généré |
| Portabilité | JPA | Spécifique à Hibernate | JPA | JPA |
| Intérêt principal | Simplicité | Réduire le N+1 en conservant LAZY | Charger immédiatement un graphe connu | Déclarer le graphe sans écrire le JOIN FETCH |
Représentation des stratégies:
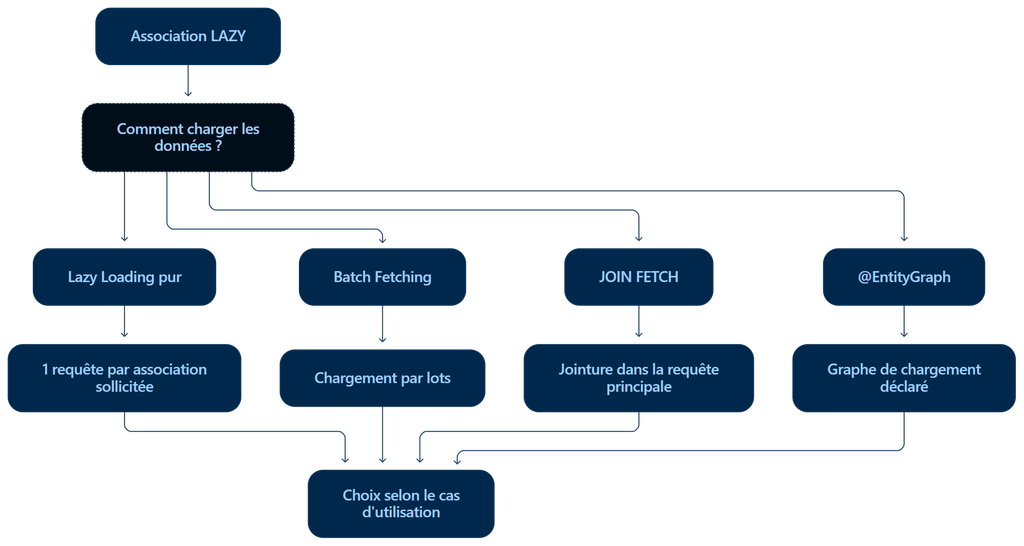
Le résultat de notre expérience permet de constater que réduire le nombre de requêtes est important, mais ce seul indicateur ne permet pas de déterminer automatiquement la meilleure solution.
Une requête unique avec plusieurs jointures peut être plus coûteuse qu’un petit nombre de requêtes simples lorsque le volume de données devient important. À l’inverse, multiplier les requêtes unitaires peut devenir très coûteux lorsque le nombre d’entités augmente.
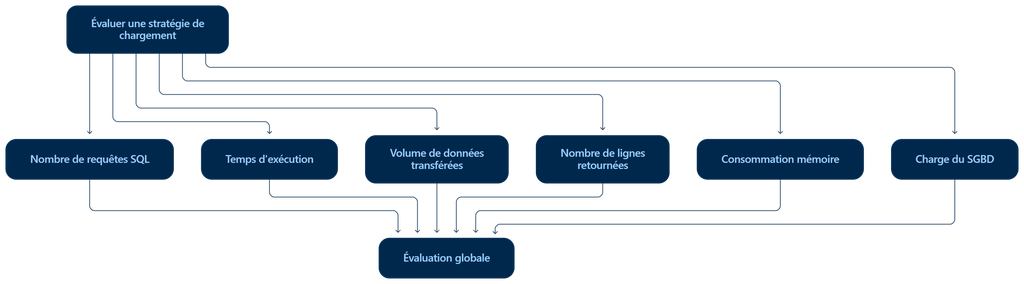
Le choix doit donc être guidé par le besoin du cas d’utilisation et par l’observation du comportement réel de l’application : SQL généré, volume de données, temps d’exécution, consommation mémoire et fréquence d’utilisation de la requête.
Dans notre expérience, le Batch Fetching constitue une protection générale intéressante contre le N+1, tandis que JOIN FETCH et @EntityGraph permettent d’exprimer plus précisément les besoins de chargement d’un cas d’utilisation donné.
6. Quelle stratégie choisir en production ?
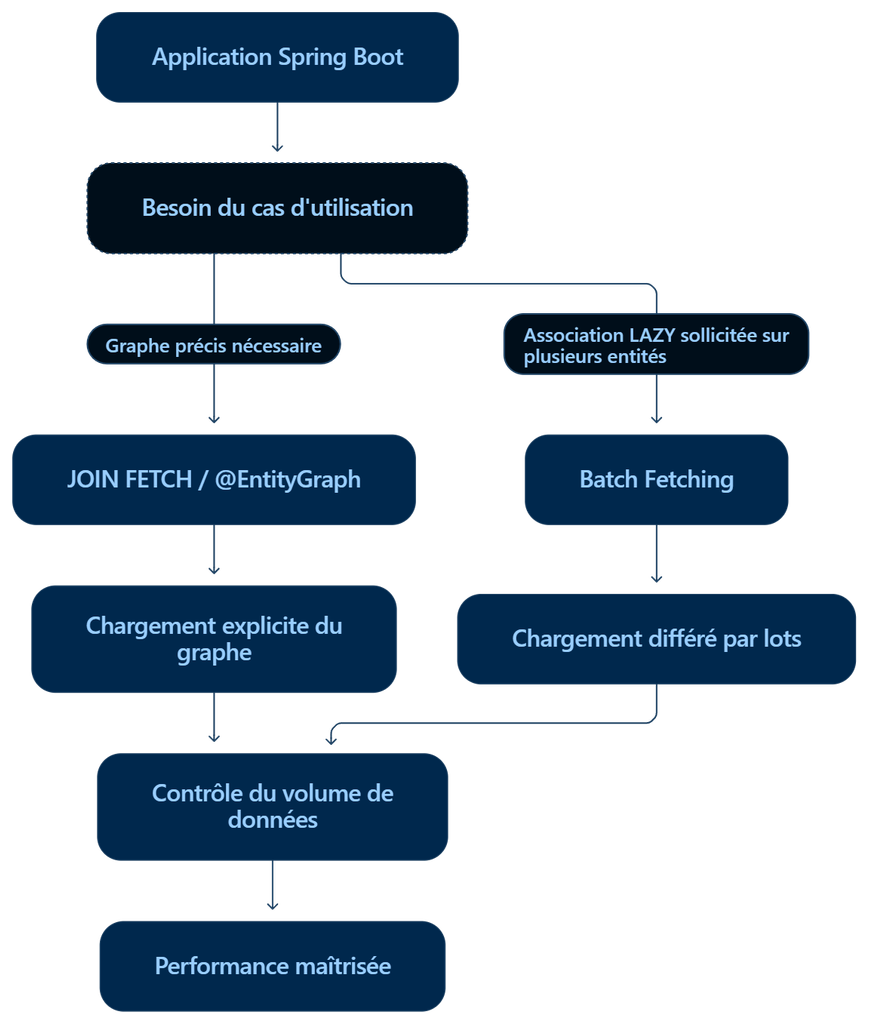
Dans une application réelle, il serait risqué de choisir une seule stratégie de chargement et de l’appliquer indistinctement à toutes les relations. Le comportement optimal dépend du cas d’utilisation, du volume de données et du graphe d’objets nécessaire.
Pour notre scénario, une stratégie hybride est plus pertinente.
JOIN FETCH ou @EntityGraph peut être utilisé lorsqu’un cas d’utilisation métier nécessite explicitement un graphe de données déterminé. Par exemple, si un service doit produire un relevé complet contenant un investisseur et l’ensemble de ses portefeuilles, il est cohérent de demander explicitement le chargement de cette association.
Le Batch Fetching joue un rôle différent. Il peut être configuré comme mécanisme de protection général afin de limiter l’impact d’un chargement différé lorsqu’une association est sollicitée sur plusieurs entités.
L’objectif n’est donc pas de remplacer systématiquement le LAZY par une autre stratégie, mais de contrôler le chargement des associations au niveau où le besoin est réellement connu.
Stratégie hybride:
Recommandation de configuration globale:
spring:
  jpa:
    properties:
      hibernate:
default_batch_fetch_size: 32Dans une architecture d’entreprise, le hibernate.default_batch_fetch_size peut être utilisé comme garde-fou global.
L’idée est simple : toutes les associations LAZY ne peuvent pas être optimisées individuellement au même niveau de précision. Une configuration globale de Batch Fetching permet donc de réduire le risque qu’un accès à une association différée entraîne une succession importante de requêtes unitaires.
Dans notre exemple, une taille de batch de 32 constitue un paramètre de départ. Cette valeur n’est cependant pas une constante universelle : elle doit être évaluée avec les caractéristiques réelles de l’application, du SGBD et des volumes de données.
Pour les cas d’utilisation critiques, il reste préférable d’analyser explicitement la requête et de choisir le graphe de chargement adapté.
Une règle pratique peut être retenue :
Si le cas d’utilisation sait précisément quelles associations sont nécessaires, privilégier un chargement explicite avec JOIN FETCH ou @EntityGraph.
Si le chargement reste différé et que plusieurs entités risquent de solliciter la même association, le Batch Fetching constitue une protection efficace contre le N+1.
Dans tous les cas, la décision doit être validée par l’observation du SQL réellement généré et par des mesures de performance représentatives.
7. Valider les stratégies avec des tests d’intégration
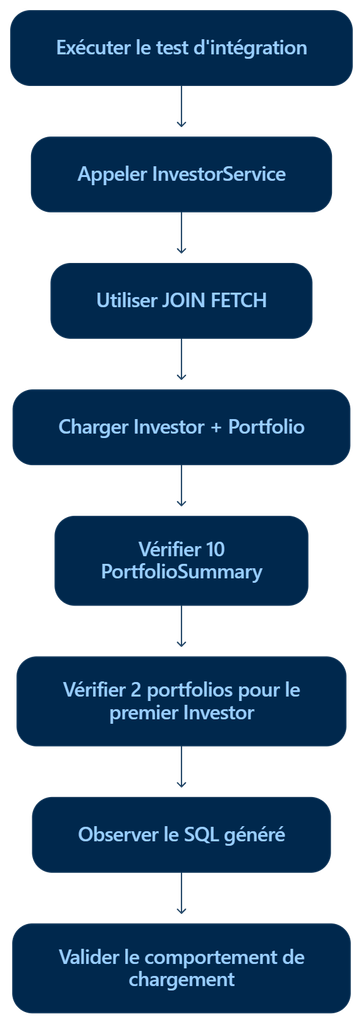
Une optimisation de performance ne devrait pas reposer uniquement sur une hypothèse concernant le comportement d’Hibernate. Il est préférable de vérifier le comportement réellement observé en exécutant l’application et en contrôlant les requêtes SQL générées.
Dans notre projet, nous avons donc associé chaque stratégie de chargement à un test d’intégration. L’objectif est de vérifier que le résultat fonctionnel reste identique tout en observant la différence de comportement au niveau de la persistance.
Pour JOIN FETCH, le test vérifie notamment que les 10 investisseurs attendus sont retournés et que le premier investisseur possède bien ses deux portefeuilles. Le scénario est exécuté à travers le service afin de tester le comportement réel de la couche Spring Data JPA et d’Hibernate.
Cette approche est importante car elle permet de valider l’optimisation dans un contexte proche de celui de l’application, plutôt que de se limiter à examiner la requête JPQL.
Test d’intégration JOIN FETCH:
package com.aroolia.performance.batchfetching;

import com.aroolia.performance.batchfetching.dto.PortfolioSummary;
import com.aroolia.performance.batchfetching.service.InvestorService;
import org.junit.jupiter.api.DisplayName;
import org.junit.jupiter.api.Test;
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.test.context.SpringBootTest;

import java.util.List;

import static org.assertj.core.api.Assertions.assertThat;

@SpringBootTest
class JoinFetchIntegrationTest {

    private static final Logger log =
            LoggerFactory.getLogger(JoinFetchIntegrationTest.class);

    @Autowired
    private InvestorService investorService;

    @Test
    @DisplayName("Doit charger l'ensemble des données en une unique requête SQL via JOIN FETCH")
    void givenJoinFetch_whenFetchingPortfolios_thenExecutesSingleQuery() {

        // GIVEN: Données initialisées

        // WHEN: Appel avec JOIN FETCH
        log.info(">>>>>> DEBUT DU TEST JOIN FETCH <<<<<<");

        List<PortfolioSummary> summaries =
                investorService.getInvestorSummariesWithJoinFetch();

        log.info(">>>>>> FIN DU TEST JOIN FETCH <<<<<<");

        // THEN: Résultat identique, obtenu en 1 seule requête SQL
        assertThat(summaries)
                .as("La liste doit contenir exactement 10 résumés")
                .isNotNull()
                .hasSize(10);

        assertThat(summaries.get(0).portfolioCount())
            .as("L'investisseur doit avoir ses 2 portefeuilles")
            .isEqualTo(2);
    }
}
Les tests réalisés sur le scénario de 10 investisseurs permettent de comparer directement les trois comportements.
Avec le Lazy Loading sans optimisation, Hibernate génère 11 requêtes : une requête pour les investisseurs et une requête pour les portefeuilles de chacun des 10 investisseurs.
Avec le Batch Fetching, le nombre descend à 2 requêtes : une requête initiale pour les investisseurs et une requête groupée pour les portefeuilles.
Avec JOIN FETCH, le scénario est exécuté avec une seule requête SQL contenant la jointure entre les deux tables.
| Stratégie | Requêtes SQL pour 10 investisseurs | Comportement |
|---|---|---|
| Lazy Loading sans optimisation | 11 | N+1 classique |
| Batch Fetching | 2 | Chargement différé groupé |
JOIN FETCH | 1 | Chargement direct |
8. Mesurer les performances au-delà du simple nombre de requêtes.
Le nombre de requêtes SQL constitue un indicateur important pour identifier un problème de N+1, mais il ne suffit pas à lui seul pour déterminer la performance globale d’une stratégie de chargement.
Dans notre expérience, les trois stratégies produisent des comportements différents : 11 requêtes avec le Lazy Loading non optimisé, 2 avec le Batch Fetching et 1 avec JOIN FETCH.
Cette réduction du nombre de requêtes est significative, mais une analyse de performance complète doit également tenir compte du volume de données retourné, de la complexité des requêtes SQL, du nombre de lignes produites par les jointures et de la consommation des ressources côté application et base de données.
Une requête unique n’est donc pas automatiquement synonyme de meilleure performance. Une jointure importante peut retourner un volume de données supérieur à plusieurs requêtes ciblées. À l’inverse, un grand nombre de petites requêtes peut générer des coûts importants liés aux allers-retours entre l’application et le SGBD.
La bonne démarche consiste donc à observer le comportement réel de chaque stratégie dans le contexte du cas d’utilisation concerné.
Les dimensions à observe:
Comparer les requêtes:
La première étape consiste à observer le SQL réellement généré par Hibernate.
Dans notre scénario, cette observation permet déjà de mettre en évidence le problème : le Lazy Loading produit une requête initiale suivie de requêtes individuelles pour les collections, tandis que le Batch Fetching regroupe les chargements et que JOIN FETCH récupère les données dans une même requête avec une jointure.
Cette observation du SQL est particulièrement utile pendant le développement et lors des tests d’intégration. Elle permet de vérifier que l’intention exprimée dans le repository correspond effectivement au comportement obtenu au niveau de la base de données.
Principe de mesure:
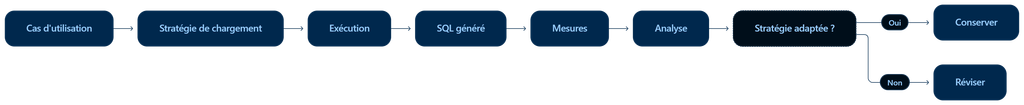
L’objectif d’une optimisation n’est donc pas de rechercher le chiffre le plus faible possible en matière de requêtes SQL. Il est de trouver un compromis adapté entre le nombre d’accès à la base, le volume de données récupéré et le coût global du traitement.
Dans notre exemple, JOIN FETCH obtient le nombre minimal de requêtes sur le scénario testé. Le Batch Fetching présente cependant un autre avantage : il conserve le chargement différé et permet de limiter le nombre de requêtes lorsque plusieurs associations sont sollicitées.
Cette distinction devient essentielle lorsqu’une application évolue et que les volumes de données deviennent plus importants. Une stratégie qui fonctionne parfaitement sur quelques dizaines d’enregistrements doit être réévaluée lorsque le même cas d’utilisation doit traiter des milliers ou des millions de données.
9. Les erreurs fréquentes à éviter avec Hibernate et le N+1
Le problème du N+1 ne vient pas nécessairement d’une mauvaise utilisation de Hibernate. Il apparaît souvent lorsque le comportement du chargement des associations n’est pas pris en compte au moment de concevoir le cas d’utilisation.
Certaines pratiques peuvent cependant rendre le problème plus fréquent ou plus difficile à détecter. Les identifier permet de mieux maîtriser les performances de la couche de persistance.
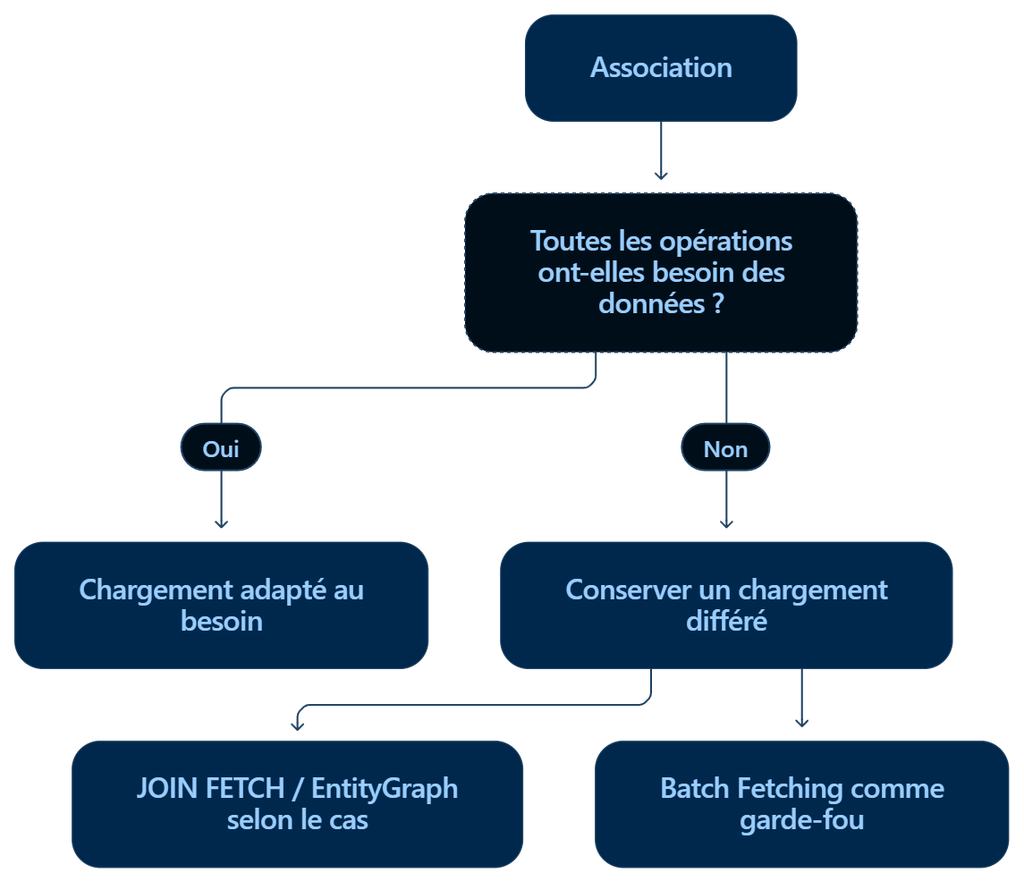
Remplacer systématiquement LAZY par EAGER
Passer une association en EAGER peut sembler être une solution simple au N+1. Pourtant, cela déplace le problème plutôt qu’il ne le résout nécessairement.
Une association configurée en EAGER demande au fournisseur JPA de charger cette relation lorsque l’entité est récupérée. Cette décision devient alors valable pour les différents usages de l’entité, y compris ceux qui n’ont pas besoin de cette association.
Dans une application comportant plusieurs relations, multiplier les associations EAGER peut conduire à charger beaucoup plus de données que nécessaire.
Il est généralement préférable de conserver un mapping adapté au comportement général du domaine et de contrôler explicitement le graphe nécessaire au niveau des requêtes ou des cas d’utilisation.
Utiliser JOIN FETCH sans contrôler le volume
Une requête JOIN FETCH permet de récupérer une association dans la requête principale, mais elle peut également augmenter considérablement le nombre de lignes produites lorsque les collections sont importantes.
Il faut donc éviter de considérer « une seule requête SQL » comme un objectif suffisant. La requête doit également rester raisonnable en matière de volume de données et de complexité.
Avant d’utiliser plusieurs JOIN FETCH, il est préférable d’examiner le graphe réellement nécessaire au cas d’utilisation et le volume de données susceptible d’être retourné.
Ne pas vérifier le SQL réellement généré
Le code Java ou JPQL ne suffit pas à comprendre complètement le comportement de la couche ORM.
Hibernate traduit les requêtes et les stratégies de chargement en SQL. C’est donc ce SQL qu’il faut observer pour comprendre le nombre réel de requêtes exécutées et la structure des accès à la base.
Dans notre expérience, l’observation des requêtes permet précisément de distinguer les trois comportements : 11 requêtes avec le Lazy Loading non optimisé, 2 avec le Batch Fetching et 1 avec JOIN FETCH.
L’optimisation doit ainsi être vérifiée au niveau de la base de données et non uniquement au niveau du code applicatif.
Optimiser sans test de performance représentatif
Une optimisation observée sur un petit jeu de données ne permet pas nécessairement de prédire le comportement de l’application en production.
Notre scénario utilise 10 investisseurs afin de mettre clairement en évidence le comportement des différentes stratégies. Pour une application réelle, il faut également tester avec des volumes représentatifs du cas d’utilisation.
L’objectif est de mesurer le comportement de la requête, son temps d’exécution, le volume de données retourné et la consommation des ressources avant de généraliser une décision d’architecture.
Considérer le nombre de requêtes comme unique indicateur
Réduire 11 requêtes à une seule est un résultat intéressant dans notre scénario, mais cela ne signifie pas qu’une requête unique sera toujours plus performante que plusieurs requêtes.
Une requête complexe peut demander davantage de travail au SGBD et retourner beaucoup plus de données. À l’inverse, plusieurs requêtes simples peuvent devenir coûteuses lorsqu’elles sont exécutées en très grand nombre.
La bonne stratégie consiste donc à considérer simultanément le nombre de requêtes, le volume de données, la complexité SQL et le temps d’exécution.
Le problème des requêtes N+1 avec Hibernate n’est pas simplement un problème de nombre de requêtes SQL. Il révèle surtout une question d’adéquation entre le modèle objet, la stratégie de chargement des associations et le besoin réel du cas d’utilisation.
Dans notre exemple, le comportement initial avec LAZY entraîne une requête pour récupérer les investisseurs, puis une requête supplémentaire pour chaque investisseur lorsque la collection portfolios est consultée. Avec 10 investisseurs, cela conduit à 11 requêtes SQL.
Le Batch Fetching permet de conserver le chargement différé tout en regroupant les chargements de plusieurs associations dans des requêtes utilisant IN. Il constitue une stratégie intéressante lorsqu’une association reste généralement LAZY, mais qu’elle risque d’être consultée pour plusieurs entités au cours d’un même traitement.
JOIN FETCH adopte une approche différente. La relation nécessaire au cas d’utilisation est explicitement chargée dans la requête JPQL. Dans notre exemple, les investisseurs et leurs portefeuilles sont récupérés dans une même requête SQL. Cette approche donne un contrôle précis sur le graphe d’objets nécessaire à une opération donnée.
@EntityGraph permet d’obtenir une intention similaire tout en exprimant la stratégie de chargement directement au niveau de la méthode du repository. Il peut rendre certaines requêtes Spring Data JPA plus lisibles lorsque l’objectif est simplement de déclarer les associations qui doivent être chargées.
Il n’existe donc pas une solution universelle au problème du N+1. Le choix dépend du cas d’utilisation, du volume de données, de la structure du graphe d’entités et de la manière dont les données sont consommées.
Une règle d’arbitrage simple peut être retenue :
- Si une association doit être chargée systématiquement pour un cas d’utilisation précis, privilégier
JOIN FETCHou@EntityGraph. - Si l’association doit rester
LAZY, mais qu’elle est susceptible d’être consultée pour plusieurs entités au cours d’un même traitement, le Batch Fetching constitue une bonne stratégie. - Si le volume de données peut devenir important, éviter de charger automatiquement un graphe d’objets trop large et préférer une requête adaptée au besoin réel.
- Si le problème concerne une liste destinée à une API ou à une interface utilisateur, envisager également une projection ou une requête dédiée plutôt que de charger inutilement les entités complètes.
- Dans tous les cas, valider la décision avec des mesures réelles : requêtes SQL générées, temps d’exécution, volume de données transférées et consommation mémoire.
Le point essentiel est donc de ne pas considérer LAZY, Batch Fetching, JOIN FETCH et @EntityGraph comme des solutions concurrentes qu’il faudrait appliquer partout. Ce sont des mécanismes différents permettant de contrôler le chargement du graphe d’objets selon les besoins du système.
En architecture logicielle, l’objectif n’est pas de supprimer le plus grand nombre possible de requêtes SQL. L’objectif est d’obtenir un accès aux données prévisible, cohérent avec le cas d’utilisation et suffisamment performant pour le volume attendu.
Le N+1 devient alors un problème architectural à traiter au niveau du cas d’utilisation, et non simplement une anomalie à corriger au niveau d’une annotation Hibernate.
Code source complet : https://github.com/cameldjoulako/eco-invest/
Recent Post
- créer cette variable ;
- lui assigner une valeur.
- le nom que nous donnons à la variable ;
- le signe égal qui est l’opérateur d’assignation (ou d’affectation) ;
- la valeur que nous assignons à la variable.
- elle comporte le signe égal puis le nom que nous avons choisi pour cette variable que nous avons appelée $variable. Le choix du nom de la variable est libre, mais pour plus de cohérence avec la valeur qu’elle contient nous devrions nommer la variable « jour » ;
- le signe égal qui permet d’assigner une valeur à la variable ;
- la valeur que nous souhaitons attribuer à la variable. Cette valeur est ici une chaîne de caractères, il est donc nécessaire de l’entourer avec des quotes ;
- le point-virgule est obligatoire et indique la fin de l’instruction.
- le signe égal n’est pas utilisé en PHP pour établir une égalité arithmétique. Le signe égal est utilisé uniquement pour assigner une valeur à une variable ;
- assigner une valeur à une variable équivaut à créer cette variable. On dit que la variable est déclarée ;
- choisir un nom pertinent pour la variable. Il est pertinent d’envisager un nom en rapport avec le type d’information qu’il contient. Ainsi, une variable à laquelle on attribue des prénoms aura tout intérêt à être nommée $firstnames (prénoms en anglais) et non pas $city ou $paysArray ;
- le nom de la variable est libre. Cependant il doit respecter les règles de nommage détaillées ci-après et doit être explicite (on doit pouvoir comprendre ce qu’elle contient).
- un nom de variable ne contient pas d’espace ;
- un nom de variable ne contient pas de caractères spéciaux ni accentués (e, ô, ù, *, #, etc.) ;
- un nom de variable doit commencer par une lettre ;
- un nom de variable doit être explicite, et de préférence en anglais (langue internationale) ;
- un nom de variable, s’il contient plusieurs mots, doit se noter en lowerCamelCase : la première lettre du premier mot en minuscule et la première lettre des mots suivants en majuscule (exemple : $maVariableEstLongue) ;
- le nom est sensible à la casse (majuscule/minuscule). Ainsi $abc est une variable différente de $ABC, $Fruit est une variable différente de $fruit.
- la déclaration d’une variable à laquelle nous assignons un nom de saison (automne). Cette variable sera donc nommée $saison et l’affichage de ce que contient la variable avec la fonction echo ou var_dump pour le débogage ;
- l’affectation d’une longue chaîne de caractères (plusieurs phrases) à une variable ;
- la déclaration d’une variable contenant un nombre entier (pour stocker un nombre dans une variable, les quotes ne sont pas nécessaires) ;
- l’affectation à une variable $saved d’une autre variable $number.
- nous ouvrons une parenthèse ;
- nous écrivons le nom de la constante entre deux quotes ;
- nous ajoutons une virgule pour séparer le nommage de la constante avec la définition de sa valeur ;
- nous écrivons ensuite la valeur de la constante (en utilisant les quotes si cette valeur est une chaîne de caractères) ;
- nous fermons la parenthèse ;
- le point-virgule indique la fin de l’instruction.
- un titre ;
- une image ;
- un texte court.
- le titre sera : « Le printemps » ;
- l’image sera fournie par le fichier image que nous allons renommer : « printemps.jpg » ;
- le texte court sera : « Le printemps est l’une des quatre saisons des zones tempérées, suivant l’hiver et précédant l’été. Le printemps se caractérise par un radoucissement du temps, la fonte des neiges, le bourgeonnement et la floraison des plantes. »
- récupérer le contenu de la page (texte et image) et vérifier que nous avons l’ensemble du contenu (il est fourni ci-dessus pour être copié-collé) ;
- préparer les outils : démarrer votre éditeur de code, démarrer votre serveur ;
- créer un nouveau répertoire saison dans Wamp sous www ;
- créer un nouveau fichier saison.php et l’enregistrer dans le répertoire www/saison.
- $seasonName : le nom de la saison ;
- $seasonDescription : le paragraphe de description de la saison ;
- $seasonImage : le nom de l’image de la saison.
Les variables et les constantes
Les variables sont un élément fondamental de tout langage de programmation. PHP permet de manipuler des informations qui peuvent être de natures très diverses. Les informations sont également appelées des données. Elles peuvent être des nombres, des chaînes de caractères, des tableaux, des résultats mathématiques, etc. Les variables sont considérées comme des boîtes pratiques dans lesquelles nous rangeons ces données que nous pourrons ensuite utiliser ou modifier quand nous le voulons. Les variables en PHP sont écrites avec le symbole dollar $ qui permet d’identifier une variable, suivi du nom de la variable. Elles sont donc sous la forme : $nomDeLaVariable. Elles peuvent contenir des informations très variées. Par exemple, nous pouvons enregistrer dans une variable le jour de la semaine (prenons lundi). Cette variable que nous pourrions appeler $jour sera utilisable en permanence tout au long de notre script et sa valeur pourra être modifiée lorsque le jour de la semaine changera. Cette variable pourra donc contenir « lundi » ou « mardi » ou n’importe quel jour de notre choix. Nous disons que « lundi » ou « mardi » est la valeur contenue dans la variable.
Déclarer une variable
Une variable se déclare simplement avec le signe égal = que nous appelons l’opérateur d’assignation et qui assigne (ou affecte ou attribue) une valeur à la variable.
Signe =
Faites très attention, le signe égal = sert à associer une valeur. Pour tester une égalité, vous devrez utiliser un double égal ==.
Le fait de déclarer une variable revient à :
La syntaxe permettant la déclaration d’une variable est la suivante :
$nomDeLaVariable = x
Déclaration de la variable
Cette déclaration ne doit pas être lue de la gauche vers la droite mais de la droite vers la gauche. Nous ne devons pas dire ou penser « $nomDeLaVariable égal valeur » mais nous assignons la valeur x à la variable « nomDeLaVariable ».
Étudions cette syntaxe. Sur la même ligne, nous avons :
Nous utilisons de manière synonyme les verbes « assigner » ou « affecter ». Ils signifient que nous attribuons une valeur à une variable. Autrement dit, nous déclarons que la variable contient cette valeur.
Si nous reprenons l’exemple de jour de la semaine et si nous souhaitons assigner à la variable la valeur « lundi » nous aurons le code suivant :
1 $variable = ‘lundi’;
Étudions cette instruction :
1 $jour = ‘lundi’;
Autre exemple de création d’une variable :
1 $saison = ‘été’;
2 echo $saison;//affiche été
Soulignons ici quatre points importants :
Nommer une variable
Les règles de nommage des variables qui suivent doivent obligatoirement être respectées :
Conventions de nommage
Pour aller plus loin et en savoir plus sur les conventions de nommage, reportez-vous aux publications de l’organisation PHP-Fig https://www.php-fig.org/psr/
Utiliser une variable
Nous venons donc de voir comment assigner une valeur à une variable.
L’exemple suivant nous montre :

Concaténer une variable
Il est souvent nécessaire d’afficher un texte qui doit contenir une variable.
Par exemple, nous pouvons afficher un texte contenant le nom d’une saison et une description de cette saison. Nous avons vu que les chaînes de caractères (en anglais : string) nécessitent des quotes pour être affichées tandis que les variables n’en ont pas besoin.
Pour afficher en même temps une chaîne de caractères et une variable, il suffit de placer ces deux éléments l’un après l’autre en les séparant par un point.
Le point permet de juxtaposer les deux éléments. On parle d’opérateur de concaténation. Il est recommandé de mettre un espace avant et après le point pour une meilleure lisibilité.
Exemples :

La concaténation est une syntaxe fondamentale de PHP et il importe de bien vérifier la succession des quotes (pour les chaînes de caractères) et des points (pour la concaténation).
Modifier la valeur d’une variable
Une variable se modifie aisément. Pour ce faire, il suffit de simplement lui assigner une autre valeur.
Exemples :

Utilisation du signe « égal »
Comme nous l’avons vu, le signe « égal » n’établit pas l’égalité, mais il permet d’assigner une valeur. Le résultat de l’addition $number + 1 est une valeur que nous pouvons tout à fait affecter à la variable $number.
Définir une constante
Les constantes sont très utiles pour manipuler une valeur qui n’est pas destinée à évoluer, ce qui permet d’optimiser votre code en prenant moins de mémoire.
Une constante est donc une valeur définie de façon permanente, et dans certains cas, il peut être envisagé d’utiliser une constante plutôt qu’une variable, car nous venons de voir qu’une variable pouvait être aisément modifiée, ce qui n’est pas le cas d’une constante.
Une constante aura un nom de constante et une valeur. Par convention, le nom de la constante est en lettres capitales (majuscules). Elle n’est précédée d’aucun signe.
Pour déclarer une constante, nous utilisons la fonction PHP define :
Ainsi, si nous souhaitons déclarer puis afficher une constante contenant le nom d’un pays :

Autre exemple
Si nous souhaitons déclarer puis afficher une constante contenant le nom de la page d’accueil :

Il est à retenir que les constantes ont un rôle très spécifique et sont beaucoup moins utilisées que les variables.
Créer une page simple
Nous avons effectué nos premiers pas en PHP et il est temps de passer à la pratique. Nous allons donc créer un projet qui consiste à produire une page web simple permettant une mise en application des aspects étudiés jusqu’à présent dans ce cours.
Demande (ou besoin)
Le besoin consiste à créer une page web qui présente une saison (le printemps) en utilisant nos connaissances PHP, notamment l’affichage des chaînes de caractères et l’utilisation des variables.
Nous souhaitons que cette page offre le contenu suivant :
Afin de réaliser cette page, nous allons récupérer le contenu provenant de la page Printemps du site Wikipédia et dont l’URL est : https://fr.wikipedia.org/wiki/Printemps.
Préparation
Afin de traiter au mieux la demande, nous devons préparer les éléments suivants :
Conception
Nous souhaitons donc produire une page web qui sera structurée en HTML.
Le titre sera intégré avec l’élément HTML title et h1, le paragraphe avec p et l’insertion d’image avec img.
Dans ce cours, nous ne vous présentons pas le code HTML, pensez à toujours respecter la sémantique HMTL complète pour que votre page soit correctement indexée et éviter des erreurs.
Cette structure pourra accueillir l’information que nous allons gérer avec PHP.
Nous notons que l’information principale est le nom de la saison et que celui-ci revient souvent dans le texte. Nous pouvons à raison penser à utiliser une variable pour afficher cette saison.
L’utilisation d’une constante pourrait être envisagée mais il faut penser que si nous réalisons une page sur le printemps, il est fort possible que nous ayons ensuite à réaliser une page sur l’été, l’hiver ou l’automne. De manière générale, et cet exercice est une bonne occasion de le constater, l’utilisation des constantes est très spécifique et est beaucoup plus rare que l’utilisation des variables.
Puisque nous allons gérer la saison avec une variable, et que cette saison peut changer, nous allons également gérer le paragraphe ainsi que l’image avec des variables.
Le nommage des variables pourra être celui-ci :
À noter qu’en tant que développeur, nous sommes libres de gérer comme nous l’entendons cette demande. Il serait tout à fait possible par exemple de nommer différemment les variables ou de ne pas assigner le texte à une variable. Ceci est une première démonstration du fait que le développement autorise des conceptions variées.
Mise en œuvre
Nous commençons par déclarer nos variables :

Intégration HTML
Du code HTML peut être écrit dans un fichier PHP. Si le code HTML est placé en dehors des balises PHP, ce code HTML ne sera pas interprété par PHP mais son rendu sera visible dans le navigateur.
Notons ici en outre que les balises PHP peuvent s’intégrer dans du HTML.

La variable contenant le nom du fichier est intégrée dans l’attribut src de l’élément img. Une image devant contenir un attribut alt, nous intégrons donc la variable contenant le nom de la saison dans cet attribut.

La variable contenant le texte est intégrée dans l’élément p.

Code complet

Rendu de la page (simplement stylisé)

